AI 系统 · 含证明与测量的研究论文 · 研究原型(仿真与游戏)
失败优先模型
失败成为结构。结构改变下一次尝试。一个模型如何只从自己真正经历过的失败中学习,把每一条教训保存为引用其证据的规则,并且永远不扩大自己被允许做的事。
一个从经验中学习的模型,必须先失败才能学到东西:一条规则只能由它所防止的那次失败的证据来证明其合理。设计上的问题在于失败可以通向哪里。我们定义失败优先模型:它只从环境(而不是模型自己)验证过的失败中学习;把每一次失败保存为一条引用其背后失败的显式约束;并且不更新任何权重。失败优先与失效安全是同一个模型的两个名字:失败优先说的是它如何学习,失效安全说的是这种学习永远不能改变什么。当权限在学习者之前、由有出处的许可和人的指令计算出来,而学习者只能删除和重排选项时,对任意学习者状态,每一个决策都落在可容许集合或安全保持之内(定理 1),并且一条指令的优先级高于任何数量的经验(定理 2)。证据如下:在真实的 Atari 2600 ROM 上、从原始像素出发,同一个失败记忆在 Space Invaders 上提升 32%,在 Freeway 上下降 12%,因为当风险与目标共用同一个动作时,规避失败就会失效;54 条各自有据的规则得分低于完全没有规则,而按覆盖度让规则退役可把死路从 6 个降到 0 个;在 DOOM 上记忆与基线持平(\(t=0.78\));在 Fallout 中,修正一个归因错误之后,一个在实时运行中于同一名守卫面前死了 49 次的驾驶员,在脚本场景中只死一次,随后选择和平的台词;一架仿真无人机在 7 轮内重新学会一条被清空的航线。把一个模型准确率 85.8% 的猜测当作事实接纳,使正确识别率从 1.000 降到 0.753。
失败优先,是模型学习的方式。失效安全,是这种学习永远不能改变的东西。
1 · 引言:每个模型都会失败
每个模型都会失败。控制器漂向障碍物,游戏智能体走回杀死过它的那场战斗,语言模型陈述一个并不成立的事实。大部分工程努力都花在让失败少一些上。本文关心的是另一个问题,也是工程师对刹车、电梯和反应堆提出的那个问题:当它失败时,失败会通向哪里?
一个从经验中学习的模型无法回避这个问题,因为它无法从一次没有经历过的失败中学到规则。一个动作被尝试之前,没有任何证据表明它会失败,只有猜测。有两类系统绕开了这一点。从不学习的系统只携带事先写好的规则;它们不必失败,但永远不会比它们的作者更好。在大型语料上训练的系统以二手方式继承别人的失败,形式是它们无法引用出处的统计模式。第三类系统从它自己的失败中、在它自己的环境里学习,并把每一条教训保存为一条可读的规则。我们称之为失败优先模型。
失败优先模型必须被允许失败,因此它所失败的环境必须被安排成:失败不能扩大它所做的事。正是这种安排使它失效安全。这两个词从两侧描述同一个模型:先失败是它学习的方式;失效安全是先失败可以被接受的原因。全文使用的简短表述是:
学习循环可以改变行为。它不能改变安全地板。
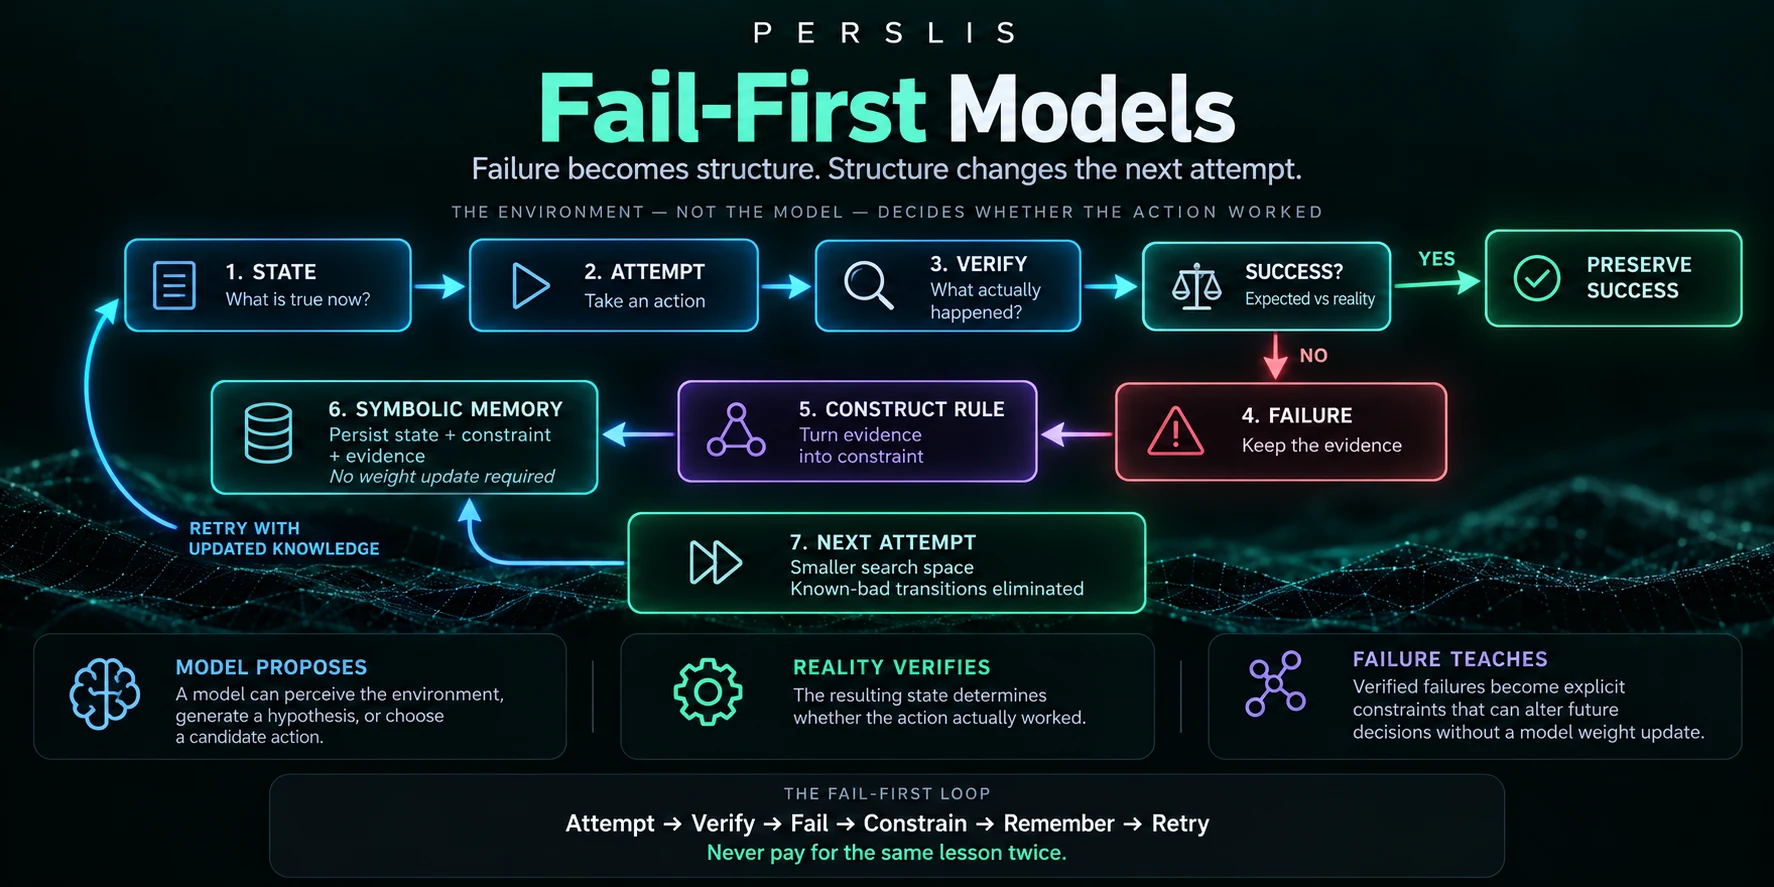
地板是决定什么被允许的一切;学习者是在被允许的事物中决定尝试什么的一切。图 1 展示了这个循环:状态 → 尝试 → 验证 →(成功:保留)或 失败(保留证据)→ 构造规则 → 符号记忆 → 下一次尝试,已知的坏转移被排除。写成一句口号:尝试 → 验证 → 失败 → 约束 → 记住 → 重试。同一课绝不付两次学费。
1.1 · 贡献
- C1. 一个定义,以及两个名字下的同一个模型(§2–§3)。我们精确地定义失败优先模型,并说明其学习者在架构上的位置——处于最内层,位于一个在它运行之前就计算好的权限之内——使它成为失效安全的。我们陈述并证明了有界学习(定理 1)、指令优先于经验(定理 2)、指令只收窄(命题 3)、“同一课绝不付两次学费”的精确形式及其两个例外(命题 4)、单纯累积单调地走向瘫痪(命题 5),以及施加在学到的计划之后的安全环节只能让它变慢(命题 6)。
- C2. 在两款真实 Atari 游戏上的测量案例研究(§4)。同一个失败记忆,读取原始 \(210\times160\) 像素、零模拟器内存、没有权重,在 Space Invaders 上提升 32%,在 Freeway 上下降 12%。这一对结果本身就是发现:当风险与目标共用同一个动作时,规避失败就会失效。我们报告了五个各自产生过貌似合理的错误答案的缺陷、饱和点(54 条规则的得分低于不学习),以及修复了一个退步却丢掉了那次胜出的后续实验组。
- C3. 同一个循环被带入运行时(§5–§7):覆盖度感知的规则退役(死路 \(6\to0\));证据瓦片,把一次拒绝追溯到其背后的每一次死亡;一个受指挥的游戏运行时(VDSG),运行在 DOOM、德军总部 3D 与 Fallout 上,由测试钉住权限边界;以及一条仿真中的无人机赛道,循环在其中从被清空的记忆重新学会航线,而一个停止距离地板作用在学到的计划之后。
- C4. 知识侧的同一纪律(§8)。失败优先模型只把经过验证的结果当作证据;失效安全模型只接纳经过验证的事实。我们报告了故意打破这一点时发生的事:一个前沿模型的猜测准确率为 85.8%,使测量成本降低 38.4%,同时使正确识别率从 1.000 降到 0.753。
1.2 · 我们主张什么,不主张什么
这里的组成部分没有一个是新的,§9 指出了每一个的来源。在运行时移除不安全的动作是屏蔽(shielding) [1];从失败中学习规则可以追溯到 PRODIGY、CHEF 与 Ripple-Down Rules [16, 9, 6];记住一次失败以免重犯同样的错误,是 Haralick 与 Elliott 的失败优先搜索的第二条原则 [10];而从灾难性失败中学习一个屏蔽,Shperberg、Liu 与 Stone 已经做过 [19, 20],这是最接近的先前工作。我们的主张恰好是这样:
据我们所知,这是第一个同时具备以下三点的模型:(1)由观察到的失败构建的规则,每条规则都引用为它赢得依据的那些失败;(2)一个在学习者之前、由有出处的卡片和人的指令计算出来的权限,并且可以证明学习者无法扩大它;(3)在做决定的循环中没有神经网络。
如果更早的系统做到了全部三点,我们会引用它。我们不主张该模型玩游戏玩得好,不主张结果能推广到所测量的环境之外,也不主张这里的任何东西有资格进入安全关键路径。每一个数据都是我们自己的,没有一个经过第三方复现。失效安全的保证只对 VDSG 运行时主张,在那里有测试钉住它;在 Atari 原型中,参数搜索层尚未与地板分离,因此不在那里主张这一保证(§10)。
2 · 失败优先与失效安全:一个模型,两个名字
失效安全(fail-safe)是一个比计算机更古老的工程术语。George Westinghouse 的自动空气制动器(1872)靠气压把刹车保持在松开状态;如果软管破裂,气压丧失,刹车便会施加。Elisha Otis 在 1854 年站在平台上、让人切断吊绳,以此演示他的安全钳。失效安全的设计并不阻止失败。它事先决定失败被允许通向哪里。
一个现代学习模型,放任不管时,会以相反的方式失败。在知识上它是“开放式失败”:被问到它不知道的东西时,生成模型仍然产出最貌似合理的续写 [11]。在约束上它会绕着约束学习:一个针对某个度量优化的系统会利用该度量的漏洞,文献称之为奖励黑客(reward hacking)或规约博弈(specification gaming) [3, 14]。如果学习者能碰到规则,最便宜的改进往往就是把规则放松。而它通常的门槛是一个数字——置信度阈值,这(§3.8)相当于给所有种类的失败标上同一个价格。
失效安全模型的构造方向正好相反。它同时具备三个性质:
- 它以关闭的方式失败。当一个答案或动作缺乏证据时,它返回未知、拒绝,或保持不动。
- 它的学习是有界的。学习者只能在一个于它运行之前计算好的权限之内删除或重排选项。任何数量的经验都不会增加一项许可。
- 它的拒绝是可问责的。每一次拒绝都指出产生它的规则,每一条学到的规则都引用为它赢得依据的失败。人可以阅读、质疑并删除其中任何一条。
失败优先模型是从“如何学习”这一侧描述的同一个模型。表 1 把两半并排列出。一个先失败却不失效安全的系统,是在靠搞坏东西来学习。一个失效安全却不先失败的系统,是一本永远不会改进的固定规则手册。只有两者都成立时它才有用。
| 失败优先 | 失效安全 | |
|---|---|---|
| 描述的是 | 它如何学习 | 学习被允许改变什么 |
| 循环步骤 | 失败、观察、解释、构建规则 | 验证、在地板之内重试 |
| 保证 | 每条规则引用为它赢得依据的失败 | 没有规则能扩大模型可以做的事 |
| 缺了另一半 | 靠搞坏东西来学习 | 安全,但永不改进 |
这些词在相邻领域的用法。“失败优先”(fail-first)及其近亲在别处有相关但不同的含义(表 2)。最近的亲戚在约束满足领域。Haralick 与 Elliott 表明,回溯搜索在遵循两条原则时会改进:先在最可能失败的地方尝试,以便尽早发现死路;并记住已经做过的事,以免重犯同样的错误 [10]。第一条原则就是此后“fail-first”一词在搜索中的含义。失败优先模型把第二条原则应用于整个模型而不是一棵搜索树:每一次失败都被记为一条规则,因此同样的错误不会犯第二次。
| 术语 | 领域 | 含义 |
|---|---|---|
| 失败优先模型(fail-first model) | AI 模型(本文) | 在一个它无法扩大的权限之内,以显式规则的形式从自己经过验证的失败中学习。 |
| 失效安全(fail-safe) | 工程 | 一次失败把系统带入安全状态(空气制动器、安全电梯)。 |
| 快速失败(fail-fast) | 软件工程 | 在第一个错误处停下,而不是在坏状态中继续运行。 |
| 容错(fault-tolerant) | 工程 | 带着故障继续运行。失效安全系统则转入不会造成伤害的状态。 |
| 失败优先原则(fail-first principle) | 约束满足 | 搜索启发式:先在最可能失败的地方分支 [10]。 |
什么时候先失败不可接受。有些失败哪怕一次也不能允许:撞到人、错误的剂量、不可逆的转账。对这些情况,失败优先的那一半不适用。地板必须事先写好,而不是学出来,学习者只在它之上运作。这就是两半之间的边界所在:学到的规则处理那些承受得起的失败;写好的规则处理那些承受不起的失败。
3 · 失败优先循环
3.1 · 循环,一步一步
图 2 画出了循环及其下方的地板;表 3 说明在后文测量的各个系统中每一步是什么。定义这一类模型的步骤是验证:由环境而不是模型决定动作是否奏效。ROM 失去一条命,游戏引擎报告一次死亡,仿真器报告一次接触或一圈用时。模型对自己表现的看法永远不会进入记忆。
| 步骤 | Atari 地板 | VDSG 与无人机 |
|---|---|---|
| 1 状态 | 从原始 \(210\times160\) 像素分桶得到的局面,零模拟器内存。 | 从引擎或仿真器状态读取的事实:生命值、在场的对象、各扇区的自由空间。 |
| 2 尝试 | 驾驶员从可容许集合中提议。 | 规则在可容许集合内选择一个目标;模型可以提议,永远不能接纳。 |
| 3 验证 | ROM 说了算:失去一条命,在真正的撞击帧读取。 | 游戏或仿真器说了算:一次死亡、一次接触、一圈用时。 |
| 4 失败 | 一张卡片:局面与所采取的动作。 | 记到开启这段经历的那个决策上:引发战斗的那句台词,而不是战斗中的那次治疗。 |
| 5 构造规则 | 只有当某个模式的 Wilson 下界超过基础率时,它才成为规则。 | 同一道门槛;一次不走运的死亡不会成为规则。 |
| 6 符号记忆 | 规则是引用经历标识符的计数,追溯为 203 个证据瓦片。 | 一张由学习者写入的证据表;许可卡片对它只读。 |
| 7 下一次尝试 | 可容许集合缩小,由规则退役设限。 | 学习者只能收窄与重排;人的指令优先于它。 |
| 成功 | 后续实验组保留每个结果的两面,因此好的动作也会被记住。 | 无人机只在该轮成本下降时保留一项改动。 |
3.2 · 先计算权限
失效安全模型不会先问“我该做什么?”。它问的是“我在这里被允许做什么?”,并从三个来源计算答案,学习者一个也改不了:局面提供了什么(基于从系统自身状态读取的事实的规则);来源许可了什么(有类型、有出处的卡片;在游戏运行时中,是从印刷版说明书编译出的卡片,每一项许可都带着它的页码凭据,存放在以只读方式打开的库中);以及人下达了什么指令(用平常语言表述的常设指令,例如“别开火”或“原地待命”,它们只能收窄)。图 3 画出了这种嵌套。
- 删除已经失败的,并引用那些失败
- 重排剩下的
- 永不添加选项
- 永不清空集合(判禁程度最轻的选项会回来)
局面规则从引擎或仿真器状态读取事实,引擎已经陈述的东西绝不从像素推断。
许可是有出处的卡片,存放在学习者只能以只读方式打开的库中。
指令满足 \(O_i(X)\subseteq X\):一句话只能拿走选项。
学习者只写入自己的证据表。
3.3 · 设定
3.4 · 保证
证明只有一行,这是有意的。这个保证不依赖于学习者聪明、正确或训练有素;它只依赖于学习者所处的位置。一个糟糕的学习者会在被允许的选项之间做出更差的选择;它无法做出一个不被允许的选择。因此定义 2 使任何失败优先的学习者在定义 4 的意义下都是失效安全的:这就是“一个模型,两个名字”的形式化内容。
定理 2 编码了一个有意的选择:人的指令优先于模型的经验。学习者可以报告某条指令代价高昂;它不能撤销它。否决永不为空也出于相关的理由:站着不动并失败不是一种适应,所以当经验判禁了一切时,判禁程度最轻的被允许选项会回来。
这三条陈述不只是写在纸上。VDSG 论文把指令收窄与有界学习者陈述为命题 [24],而 Fallout 测试套件在代码中钉住了它们(§6.3):
test_the_learner_can_never_add_a_goaltest_the_learner_cannot_overrule_a_standing_ordertest_ranking_is_a_permutation_and_nothing_more
我们在写作本文时重新运行了它们;它们通过。
“同一课绝不付两次学费”这句口号,只有把它的例外说清楚才成立。
第三个例外是运作层面的而非逻辑层面的:如果一条规则被退役(§5.1),被它判禁的目标就会回来。退役是对 \(M\) 的一次改变,因此在它之后定理 1 依然成立。之所以需要退役,原因在于下一个命题。固定一个遇到过的局面的有限集合 \(\mathcal S\),并对每个 \(S\in\mathcal S\) 固定在那里观察到的目标集合 \(\mathrm{Seen}(S)\)。对规则集 \(\mathcal R\),令 \(\mathrm{Blk}_{\mathcal R}(S)\) 为 \(\mathrm{Seen}(S)\) 中被某条规则阻止的目标,\(\mathrm{left}_{\mathcal R}(S)=\mathrm{Seen}(S)\setminus\mathrm{Blk}_{\mathcal R}(S)\),\(D(\mathcal R)=\{S:\mathrm{left}_{\mathcal R}(S)=\varnothing\}\) 为死路。
在死路中模型并不会停摆(否决会返回判禁程度最轻的目标),但这个选择已经不是由证据做出的了。因此,一个只累积规则的学习者只可能失去选择的能力。每条规则可能各自都正确,而整个集合仍然使人瘫痪;§5.1 测量的正是这一点。
3.5 · 一次失败何时成为一条规则?
规则应当在某个模式明显比平常更危险时形成,而不是在它某次运气不好时形成。对于一个被尝试 \(n\) 次、失败 \(d\) 次的模式,点估计 \(\hat p=d/n\) 在 \(n\) 较小时具有误导性:一次尝试一次失败读作 100%。因此判定使用 Wilson 得分区间的下沿 [22],
当一个模式有足够的尝试次数、且其下界以裕度 \(\mu\) 超过基础率 \(b\)(总体失败率)时,它被判禁:
我们使用 \(z=1.645\),即单侧 95% 界(等价于双侧 90% 区间的下沿);Fallout 线使用 \(z=1.64\)。表 4 与图 4 给出了计算值。
| 失败 / 尝试 | 点估计 | 下界 \(L\) | 解读 |
|---|---|---|---|
| 1 / 1 | 100% | 0.270 | 一次失败是弱证据,无论点估计怎么说。 |
| 4 / 4 | 100% | 0.596 | 连续四次是强证据。 |
| 13 / 19 | 68% | 0.496 | 对比约 0.19 的基础率,明确判禁。 |
| 3 / 4 | 75% | 0.356 | 可疑,尚未证实。 |
为什么门槛是相对的。在一个模型能在 99.5% 的决策中存活的环境里,一个 5% 概率致死的局面比平常致命十倍,必须被拒绝,但它永远接近不了像 60% 这样的绝对阈值。在 Space Invaders 上,基础死亡率是 2.8%,一道 60% 的绝对门槛从 268 次真实失败中产生了 0 条规则(§4.5)。这是一个经过测量的设计决定,而不是偏好。相对门槛有相反的风险:一个什么都会死的模型基础率接近 1,没有什么是“比平均更糟”的。因此 Fallout 线增加了两个条款:一个在至少 2 次尝试中以 \(\ge90\%\) 致死的模式被直接判禁;并且相对门槛以绝对致死率 0.6 封顶,这样模型死得越多,它能学到的就越多而不是越少。当同一局面中已尝试过足够多的替代选项时,基础率被替换为该局面中其他目标的失败率,这样一个危险的局面就不会被归咎于碰巧在其中被选中的那个目标。
3.6 · 归因:责怪正确的决策
当失败发生在时刻 \(t_f\),此前的某个决策集合 \(B(t_f)\) 会承担责任。朴素的选择——最后 \(w\) 个决策——通常是错的:紧接在失败之前的决策往往是对危险的反应,而不是危险的原因。规则必须把责任记到开启这段危险经历的那个决策上。
我们已经公开了两个我们在这件事上弄错的案例,两者都产生了可信的学习曲线。在 Atari 中,模拟器在一段 127 帧的死亡动画结束时才报告失去一条命,所以每次失败都是在飞船已经被摧毁之后才被记录的:374 个被责怪的帧中 0 个显示出危险;在真正的撞击帧上,17 个中 17 个都显示了(§4.5)。在 Fallout 中,责任只覆盖一场战斗内部的最后六个决策:26 次死亡被记到 HEAL 上,而引发这些战斗的 446 句对话回复一次也没有被记(§6.3)。归因是学习系统无声失败的地方。这就是为什么失效安全模型绝不能让一条归错了责任的规则扩大它的权限:由定理 1,一条错误的规则只会让它更谨慎。它仍然可能让模型变得无用,但那是性能上的失败,不是安全上的失败。
3.7 · 重试:不会退步的改进
当模型改进一个计划(例如一条航线)时,它一次只改变一个参数 \(\theta\),并且只有当一个明确为失败定价的成本下降时才保留这项改变。对于无人机(§7),一轮的成本为
即单圈用时,加上每次接触 \(k\) 计 \(\kappa=15\) 秒,再加上未完成的惩罚 \(P\)(60 秒,外加每差一米 2 秒),在一组固定的起点上取平均。只有当 \(C\) 比迄今最优值至少低 0.05 秒时,改变才被保留;被拒绝的动作其步长减半。因此被接受的序列按构造满足 \(C_{j+1}\le C_j-0.05\):迄今最优只会变好,而且因为仿真器是确定性的,它可以被精确重放。地板仍然作用于每一次试验,因为它作用在学到的计划之后。
在无人机的计时赛引导中,各环节依次为:当前 6 米区段学到的速度上限(绝不低于 0.8 m/s);一个停止距离环节——当 \(\sqrt{2a(d-m)}\)(其中 \(a=4\) m/s²,裕度 \(m=1.5\) 米)低于当前命令时,把命令替换为 \(\max(0.3,\sqrt{2a(d-m)})\);以及上游的反射,它在触发距离以内至多返回 0.25 m/s 或一个倒退命令。每一个都满足假设,其中停止距离界带有 0.3 m/s 的蠕行下限。该命题只涵盖前向速度;横向与垂直机动属于上游项目的反应层和地板的爬升规则。
3.8 · 什么时候拒绝是正确的决定?
考虑一个动作,失败概率为 \(p\),失败代价为 \(c\),成功时价值为 \(v\)。它优于什么都不做,当且仅当
终局性的失败会丧失此后可能发生的一切,所以 \(c\) 非常大,\(p\) 的阈值趋于零:拒绝任何明显危险的事是对的。可恢复的失败只损失进度,所以 \(c\) 很小;如果危险的动作同时也是唯一有价值的动作,拒绝它就是错的。置信度阈值为每个动作固定同一个 \(p\) 的截断点,这相当于处处假设同一个 \(c/v\)(图 5)。没有哪一个值在两种情形下都正确。这就是失效安全模型必须知道自己在规避哪一种失败的形式化理由,也是 §10 中的开放问题:Freeway(§4)是测量到的实例。
4 · 案例研究:两款 Atari 游戏
4.1 · 设定
第一个失败优先地板被用于两个真实的 Atari 2600 ROM——Space Invaders 与 Freeway,通过街机学习环境(Arcade Learning Environment,ALE 0.11.2,Stella 模拟器) [4]。三项承诺让这个结果有意义:
- 不读模拟器内存。一切都从原始 \(210\times160\) RGB 帧中按颜色读取。从模拟器内存中读出实体位置会让任务变得几乎微不足道。
- 没有权重,没有梯度。一次失败写下一张卡片:局面的一个粗粒度符号签名加上所采取的动作。当一个签名有足够的证据时(§3.5),它成为一条规则,在决策时刻把该动作从可容许集合中移除。记忆从不建议动作;它只拿走动作。如果每个候选都被判禁,就取判禁程度最轻的那一个。
- 每条规则都引用其证据。一条规则报告它的尝试次数、失败次数、观测比率、相对基础率的提升,以及构建它的经历标识符。规则还必须指出一个危险:早期没有指出危险就形成的只有两条——“屏幕空着时不要移动”,向左和向右——那正是迷信的形状。
两款游戏中的管线完全相同;只有视觉层和危险词汇不同。在 Freeway 上,代码原封不动地导入 Space Invaders 的失败记忆,没有针对单个游戏的策略。评估使用留出种子(Space Invaders 9000–9015,Freeway 900–907)、frameskip 1,并且在每次评估期间记忆都被冻结。结果于 2026 年 9 月 25 日冻结在两张实验卡上,这些卡不会为了让后来的指标更好看而被编辑;后来的版本有自己的卡,并引用它们。
4.2 · 结果
在 Space Invaders 上,记忆的价值是 \(+32\%\):随机游玩 149.5,基于规则的驾驶员 152.2,驾驶员加记忆 200.6(死亡 46 次对 43 次)。在一个更保守、含 21 条规则的工作点上,同样的比较给出 184.4 对 152.2(\(+21\%\)),死亡从 46 次降到 23 次。在 Freeway 上,完全相同的机制下降了 12%:随机 0.0,驾驶员 10.4,驾驶员加记忆 9.2。Freeway 记忆在 169 个签名上写下了 17,611 张卡片,形成了三条规则,每一条都阻止 up:car dx+2 dy+1|up(4 次中死 2 次)、car dx+4 dy+1|up(3 次中 2 次)、car dx-4 dy+1|up(3 次中 2 次)。
4.3 · 发现:失败毁掉的是什么
这一对结果本身就是发现,原因并不是某款游戏更难。在 Space Invaders 中,飞船无论往哪里闪避都每帧开火,所以安全是白来的:风险与目标是可分离的。在 Freeway 中,危险横亘在目标之上:up 既是危险的动作,也是唯一得分的动作。一个唯一操作是“我做 \(X\) 时死了,所以抑制 \(X\)”的学习者,正确地得出 up 危险的结论,并正确地停止了游戏。这条规则为真,却无用,因为有风险不等于坏。学习者知道一个动作的代价,却永远不知道它的价值。
用 §3.8 的话说:Space Invaders 中的一次死亡是终局性的。它移除了本局剩下的全部回报,所以它真正的代价是预期的剩余回报,一个绝对否决恰好——出于偶然——给它定了正确的价。Freeway 中的一次碰撞是可恢复的:小鸡被撞回去,游戏继续,所以代价只是损失的进度。一个失败价格不可能在两种情形下都正确,而置信度阈值恰恰是一个单一的失败价格。
请把这一对结果放在一起读。任何引用 \(+32\%\) 而不引用 \(-12\%\) 的人,都误读了这项工作。机制在游戏之间迁移了;学习没有。
4.4 · 饱和:54 条正确的规则比没有更糟
学习曲线(图 7)从未经训练时的 162.5 上升到 50 局后的峰值 276.2,然后在 100 局时下降到 246.7,工作集的上限为 30 条规则。去掉上限,100 局后崩溃到 167.1,共 54 条规则。这 54 条规则中的每一条都由真实的死亡单独证明,并且致死率至少 50%;合在一起,它们让驾驶员瘫痪。这就是被测量出来的命题 5:可容许集合只会缩小,所以一个从不让规则退役的地板最终会拒绝一切。给工作集设上限是承重的,不是调参细节,而这也是反对我们自己方法的论据,所以我们把这个数字说出来。
4.5 · 五个缺陷,每一个都产生过貌似合理的错误答案
实验卡记录了发现的每一个缺陷,因为每一个在被抓到之前都悄无声息地返回过一个可信的结果(表 5)。最大的是一个归因错误:地板完全是在从错误的时刻学习,却仍然产生了一条看起来像学习的曲线。我们报告这些,是因为一个只会上涨的结果不会更可信,只会更不可信。
| # | 缺陷 | 证据 |
|---|---|---|
| 1 | 归因锚定在命数计数器上 | ALE 在一段 127 帧死亡动画的结束时才减少 lives,所以卡片是在飞船被摧毁之后写下的:374 个中 0 个被责怪的帧里能看到炸弹;在真正的撞击帧上,17 个中 17 个能看到。 |
| 2 | 每帧一张卡片 | 大约 79,000 张卡片的失败率全都 \(\approx0\),所以没有签名能越过阈值,也没有规则形成。改为每次遭遇一张卡片后修复;随后 12 局之内就形成了规则。 |
| 3 | 60% 的绝对门槛 | 基础死亡率 2.8%:一个 5% 概率致死的局面是灾难性的,却永远接近不了 60%。268 次真实失败产生了 0 条规则。修复:相对提升 + Wilson 界 + 绝对致死率下限。 |
| 4 | 自己的激光与炸弹同为灰色 | 按列匹配把下落的炸弹与上升的激光配成了对:374 条轨迹中,339 条被读成“我们的”。飞船对几乎每一枚瞄准它的炸弹都是瞎的。 |
| 5 | frameskip=4 | 炸弹在 2–3 个采样内就穿过危险带:在 frameskip 4 下只在 6% 的帧中可见,在 frameskip 1 下为 76%。 |
4.6 · 后续实验组做了什么
第二张卡(V2)保留了每个(局面,动作)对的两面,并按效用——预期回报减去失败代价——排序,所以没有什么被永久排除,后来的证据可以撤销对一个坏选项的排名。一个变体(V2.1)在此之上加了一个针对灾难性结果的硬地板。表 6 给出与冻结时完全一致的结果。V2 修复了 Freeway 的退步,却丢掉了 Space Invaders 的胜出。V2.1 两者都丢了。在 Freeway 上,硬地板否决了 up(有几个 up 签名的观测致死率高于 80%),于是只是重建了 V1:当致命的动作就是唯一得分的动作时,没有什么灾难性尾部可排除。把固定的失败代价在观测回报尺度的 \(\{0.5,1,2,4\}\times\) 上扫描,Freeway 得到 \(\{10.2,7.5,10.3,7.7\}\):最好也只是持平,从未高于驾驶员。
| 实验组 | Space Invaders | Freeway |
|---|---|---|
| 仅驾驶员(不学习),V2 卡 | 139.4 | 10.3 |
| V1:仅规避 | 200.6 (对其自身的 152.2 为 \(+32\%\)) | 9.2 (\(-12\%\)) |
| V2:仅效用 | 128.8 (\(-8\%\)) | 10.2(持平) |
| V2.1:灾难性地板 + 效用 | 121.9 (\(-13\%\)) | 5.0 (\(-51\%\)) |
同一张卡还记录了另一个实验组 V2.2,它把从该时刻到本局结束的折扣回报记到每个决策上(教科书式的蒙特卡洛回报估计),因此终局性的死亡被记上全部剩余回报,而可恢复的撞回只被记上那次挫折。它在 Space Invaders 上得 157.5(比其 139.4 的驾驶员高 \(+13\%\)),在 Freeway 上得 10.0(持平);若签名按到达时间而不是原始距离给车辆分桶,Freeway 上为 11.2(\(+8\%\))。我们连同它的局限一起报告:它是一种排序,不是地板;问它偏好哪个动作,它在 17 个局面中的 13 个里选择 up,包括车辆即刻到达的时候,所以它学到的是过马路值得冒险,而不是何时过;并且同一个记忆在 DOOM 上是持平(§6.2)。一个为可恢复性定价的地板——一个硬约束——仍然是开放问题。
4.7 · 哪些东西延续了下来
有四样东西从这个原型延续到了 §5–§7 的运行时中:学习只删除(这里记忆只能拿走动作;在 VDSG 中这成了带测试的定理 1);每一次拒绝都引用其证据(计数变成了可追溯的证据瓦片);饱和崩溃得到处理,靠的是覆盖度感知的退役,目前在重放上测量;以及归因问题再次出现,并在 Fallout 中再次被抓到。有一样没有延续:风险即目标。Freeway 仍然是一个为可恢复失败定价的地板的基准;我们建造的地板没有一个胜过它的驾驶员。
5 · 从规则到运行时
表 7 是从冻结的 Atari 结果到如今承载该循环的运行时的路线,每行一步,附带其数字。负面结果予以保留。
| 步骤 | 结果 | 它教会了什么 |
|---|---|---|
| 街机地板 V1 Space Invaders、Freeway | \(+32\%\) · \(-12\%\) | 失败记忆在失败是终局性的地方有帮助,在有风险的动作是唯一有用动作的地方有害(§4)。 |
| 规则退役 54 条规则的崩溃 | 30 条规则 → 6 条死路 · 50 → 12 · 退役 → 0 | 每条规则各自有据,合起来却令人瘫痪。按覆盖度退役恢复了选择(§5.1)。 |
| 证据瓦片 每次否决都可追溯 | 4,280 张卡片 → 30 条规则 → 203 个瓦片 | 一次拒绝可以一路追溯到为它赢得依据的每一次死亡(§5.2)。 |
| VDSG · DOOM 基于规则,无神经网络 | 随机 3.2 · 规则 17.9 · + 记忆 20.3(\(t=0.78\)) | 规则决定性地胜出;其上的记忆是持平,不是胜出(§6.2)。 |
| VDSG · 指令 DOOM、德军总部 3D | 指令只收窄 · 学习者有界 | 陈述为命题;没有指令、也没有任何数量的经验能增加一个动作。 |
| VDSG · Fallout(1997) 脚本场景,真实循环 | 在同一名守卫面前死 49 次 → 只死一次 | 责任必须追到引发战斗的那句台词,而不是战斗中的那次治疗(§6.3)。 |
| 无人机赛道 仿真,留出起点 | 10/10 跑完全程,0 次接触 · 基线 1/10 | 学到的计划设定速度;停止距离限制与反射作用在它之后(§7)。 |
5.1 · 覆盖度感知的退役
对不断增长的规则集,通常的缓解办法是按每条规则自身的证据质量打分,保留最好的 \(N\) 条。V1 地板就是这么做的,而它仍然是盲目的:它孤立地给每条规则打分,从不问它们的合取会产生什么。退役给集合打分。对智能体实际遇到过的每一个局面,
其中 0 是一条死路(每个选项都被拒绝;地板变成了一堵墙),1 是被迫(只剩一个选项;智能体在那里什么也不决定)。一条规则的保护是它所解释的失败;它的代价是它推入死路或被迫的局面。退役按代价与保护之比剔除最差的规则,直到选择得到恢复。
我们在写作本文时以只读方式在 Space Invaders 的失败记忆上重新运行了这项测量:在 91 个遇到过的局面上重放 4,320 个决策(表 8、图 8)。有界的 30 条规则集留下 6 条死路和 9 个被迫局面;全部 50 条合格规则留下 12 条和 15 个。规则翻倍,死路也翻倍,这正是 §4.4 中崩溃到 167.1 的机制(54 条规则的那次运行与这次 50 条规则的重放是同一个记忆的不同快照)。退役 6 条规则把死路从 6 条降到 0 条,代价是交还 29 次已记录的失败,而被迫局面从 9 个升到 14 个:局面从没有选择变成了一个选择。退役让可容许集合得以重新长回来;由命题 5,单纯累积永远做不到。
| 规则集 | 规则数 | 死路 | 被迫 | 交还的失败 |
|---|---|---|---|---|
| 有界工作集(V1) | 30 | 6 | 9 | – |
| 无上限(全部合格规则) | 50 | 12 | 15 | – |
| 有界,然后覆盖度感知的退役 | 24 | 0 | 14 | 29 |
5.2 · 证据瓦片:一次可以追溯的拒绝
一个分类器可以报告它有 0.94 的把握。它说不出是哪些经历让它达到 0.94,它删不掉其中任何一条,事故之后也没有任何东西可读。在失败优先地板中,学到的状态本身就是解释。Space Invaders 记忆的 4,280 张卡片、它们支撑的 30 条规则,以及二者之间的链条,被追溯为 203 个证据瓦片,按父子关系相连,因此一次否决可以一路追溯到证明它合理的每一个事件。一次否决读起来是这样的:
left is removed from the admissible set when bomb dx+0 drop0:
    died 4 of 4 times (100.0%), 5.2× the base rate
    ← experience #0040    ← experience #0042    ← experience #0171    ← experience #0203
(译:当 bomb dx+0 drop0 时,left 从可容许集合中移除:4 次中死亡 4 次(100.0%),为基础率的 5.2 倍 ← 经历 #0040 ← 经历 #0042 ← 经历 #0171 ← 经历 #0203。)
计数、与基础率的比较,以及按标识符列出的各个事件。删掉一行,行为就会改变;里面没有别的东西。我们不把这称为“没有机器学习”。它是学习,因为行为随经验而改变。它所具有的是:没有权重,没有梯度,没有训练过程。瓦片格式本身属于 Peel 证据地板,这里不作描述(§10)。
6 · VDSG:DOOM、德军总部 3D 与 Fallout
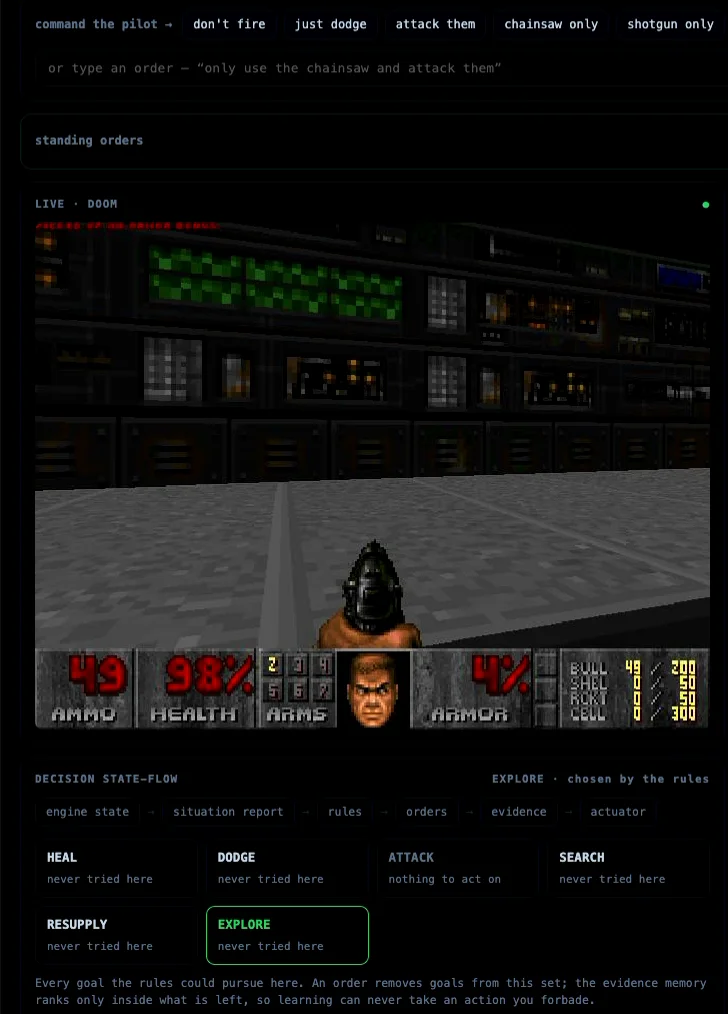
VDSG 是如今运行该循环、并钉住其保证的运行时:一个受指挥的准入控制运行时,在每一次决策时根据事实上的显式规则计算智能体可以追求的目标,允许操作员用日常语言收窄这个集合,只在集合内部从证据中学习,并写下每一个选择的理由 [24]。它是 Peel 模型在游戏中的部署,在做决定的循环中没有神经网络:它的知识是有出处的卡片,它的学习是一张计数表。
6.1 · 契约
情境报告 \(F(s)\) 是从引擎自身状态中对事实的结构化提取(敌人的方位、距离以及是否在视野中;拾取物;生命值、护甲、弹药;位置;最近的受击)。适用性函数返回那些对象确实存在的目标(ATTACK 需要视野中有敌人,HEAL 需要一个医疗拾取物),一个固定优先级的规则策略在其中选择。常设指令由其效果而不是其文字定义:它仍然允许的目标、它移除的按键,以及它可能指定的武器。解析器是一套带显式否定的固定短语词汇;它不认识的文字会被拒绝,绝不猜测。当一条指令无法被满足时(身上没有霰弹枪时的“只用霰弹枪”),运行时会说出来,附带凭据,每一次决策都说,直到可以满足为止,并回退到不含 ATTACK 的适用集合,所以一条无法满足的指令永远不会把驾驶员推入它本来不会进入的交战。VDSG 论文证明了指令只收窄、学习者受收窄后的集合约束,以及对指令的拒绝是可靠且完备的 [24]。这些性质是在开发中观察到其失效模式之后才写下的:被否定的武器被反向执行、逗号分隔的子句被合并成一句,以及一条无法满足的指令被悄悄放宽成 ATTACK。每一个现在都在构造上被排除,并由逐处测试钉住。
6.2 · DOOM
在 ViZDoom [13] 下的一个 Freedoom 死亡竞赛场地上,每个实验组使用相同的种子与节奏,基于规则的驾驶员价值约为随机的五倍,而其上的证据记忆与它拉不开差距(表 9)。配对的逐种子差值(记忆减驾驶员)在 32 个种子上均值为 \(+2.4\),标准差 17.4,\(t=0.78\),18 胜 13 负 1 平。这是噪声之内的持平,不是改进,我们如实报告。原因就是 V2 卡中指出的那个:在这个样本量下,剩余回报估计无法在一个局面之内把各个目标区分开(学到的表中排名靠前的目标彼此只差几分)。
| 实验组 | 种子数 | 回报 | 击杀 |
|---|---|---|---|
| 随机按键 | 16 | 3.2 | 1.4 |
| 规则,仅视野输入 | 16 | 14.1 | 5.6 |
| 规则 + 雷达输入(驾驶员) | 32 | 17.9 | 7.4 |
| 驾驶员 + 证据记忆(200 个训练局) | 32 | 20.3 | 8.2 |
| 配对差值(记忆 \(-\) 驾驶员):均值 \(+2.4\),标准差 17.4,\(t=0.78\);18 胜 / 13 负 / 1 平 | |||
另外两项测量连规则的优势也打了折扣。引擎的击杀计数器是地图的,会把互相残杀的怪物也算进去:一个被命令永不开火的驾驶员(已核实:八局零次扳机)仍被记了 55 次击杀。在相同的种子上分解,规则相对随机的回报大部分来自动起来本身;因此控制台的标题计数器是造成的伤害与命中数,驾驶员不开火时它们恰为零。另外,从证据轨迹中泛化出的六条失败规则中,有四条在留出局次上复现。
在真实的 1993 年共享版关卡上,驾驶员在第三难度通关 E1M1(52 秒按下出口开关),在 Nightmare 难度的 8 次尝试中都未通关(在 23–37 秒死亡)。在 E1M2 上,它每次尝试都在 10–20 秒拿到霰弹枪并持有红钥匙,却仍在 112–207 秒死亡。死因是测量出来的,不是猜出来的:在一次完整尝试的 177 点伤害中,有 144 点来自 15 米之外、从未进入视野的 Zombieman。随后的一个假设——被看不见的东西击中时后撤以切断视线——测出来更差(三次尝试平均存活 123 秒,而此前四次为 187 秒),于是被撤销;记录保留了这个数字 [24]。
德军总部 3D。同一个运行时在 1992 年的数据上暴露了两个缺陷,是循环自身的卡死规则让它们显现出来的。卡死阈值被留在了 DOOM 的地图单位,所以德军总部线在 1,014 次决策中记录了 150 次卡死事件,每八次一次;换成引擎自己的瓦片单位后为 9 次。并且因为引擎的 USE 会切换门的开关,一个在半开的门前按它的驾驶员,一直在关上它想打开的门:修复前 1,275 次决策中有 583 次耗在门前,修复后 1,184 次中 371 次。驾驶员尚未到达该关的电梯。
6.3 · Fallout(1997):让我们学到最多的失败是我们自己的
在 Fallout 线中,许可来自一份文档。游戏的印刷版说明书被编译成 2,250 张卡片;对当前局面生效的卡片许可驾驶员可以追求的目标,每一项许可都带着它的页码凭据,卡片库以只读方式打开。证据表是学习者唯一写入的库。所以有两个互不混合的库,正如图 3 所示。
49 次死亡的循环。一次实时运行中,驾驶员一次次回到同一名守卫面前、说着同一句台词,死了 49 次。学习者在工作;它是在从错误的时刻学习。三个缺陷,都是在驾驶员自己的记录中发现的:
- 一句台词的结果被早读了一个 tick。守卫先关闭对话,片刻之后才拔枪,所以 “Prepare to meet your maker”(准备去见你的造物主吧)说了四次、随后四场致命战斗,却被记为战斗 0%。
- 责任只覆盖战斗内部的最后六个决策。26 次死亡被记到 HEAL 上,而引发这些战斗的 446 句回复一次也没有被记。
- 否决使用了最宽的有害模式和点估计,对照的是每次决策约 0.5% 的基础率,所以一次死亡之后,驾驶员躲开了镇上的每一个人。
修复遵循循环:一句台词保持打开,直到被下一句台词、一场战斗、一次死亡或一段短暂的安静回应为止;在一次对话的这个宽限窗口内开始的战斗,记到开启它的那段对话上;并且一个模式只按 §3.5 的规则被判禁:在至少 2 次尝试中以 \(\ge90\%\) 致死,或者至少 4 次尝试且 Wilson 下界(\(z\approx1.64\))高于基础率加一个裕度。
修复之后。在一个经由真实决策循环驱动的 Shady Sands 脚本场景中,驾驶员死一次,然后选择和平的台词,此后每次都是如此。在没有安全台词可选时,它死两次,然后不再与那名守卫交谈,但仍然与那个孩子交谈:这条教训针对的是一个交谈对象,而不是交谈本身。这些是经由真实 Session.tick() 的脚本场景,不是一场长时间的实时战役。
钉住边界的测试。这种分离在测试套件中用一句话表述:学习者可以改写它认为有效的东西;它永远不能改写它被授权做的事。三个测试钉住了它:
test_the_learner_can_never_add_a_goal
每个目标都被“杀死”六次、权限为 {WAIT} 时,保留下来的集合仍在权限之内;test_the_learner_cannot_overrule_a_standing_order
把集合收窄为 FIGHT 的指令,在 20 次死亡之后仍然是 FIGHT;test_ranking_is_a_permutation_and_nothing_more
学习者可以重排可容许的目标,永远不能添加一个。
在 2026 年 9 月 26 日发布时,该套件有 219 个通过的测试和 1 个严格预期失败;此后它有所增长(写作本文时收集到 488 个测试)。我们为本文重新运行了这三个边界测试以及旁边那个局面约束测试;四个全部通过。
留在套件里的那个预期失败。由于只在赤手空拳时死过,最宽的模式(FIGHT,其他每个字段都用通配符)越过了门槛,判禁了持械战斗——一件从未尝试过的事。显而易见的修复——不信任一个其字段从未变化过的通配符——也会破坏一个正确的情形:从单一名字出发在敌人名字上进行泛化。两者在逻辑上是对称的:证据中没有任何东西说明哪个字段是因果性的,替学习者做选择就等于把教训硬编码进去。补救办法是探索——偶尔在其具体细节从未尝试过的情境中测试一个被判禁的目标——而这还没有建成。在建成之前,该测试被标记为严格预期失败。
7 · 无人机
7.1 · 设定
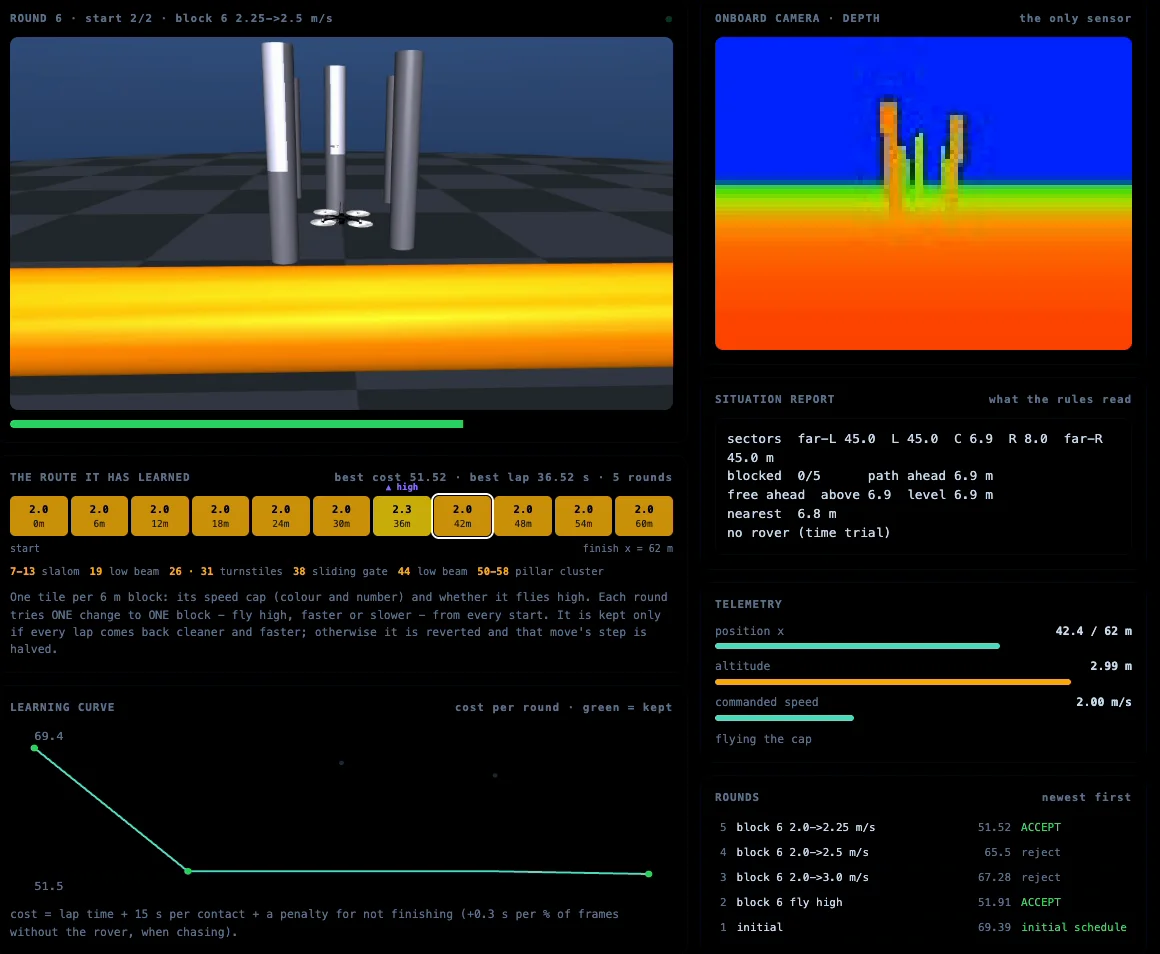
赛道与飞行器来自一个开源项目 jev-drone [12],固定在上游提交 974b473,未作编辑:一个 MuJoCo [21] 仿真,一架 Skydio X2 四旋翼飞行器飞过一条 62 米的赛道,其中有绕桩、低横梁、旋转门、滑动门和一簇柱子。上游的飞行控制器、机载深度相机、反射距离与高度都按原样使用。只替换了一个接缝:决定做什么的战术层被地板替换,输入与输出不变。规则读取的唯一传感器是机载深度图,被概括为各扇区的自由空间、前方路径和最近的障碍物。整个循环中任何地方都没有神经网络。
7.2 · 结果,以及附带的保留意见
在留出的起始位置上、于规则冻结之后运行一次,地板 10 次中 10 次飞完全程,0 次接触。未经修改的基线完成了 10 次中 1 次。保留意见永远与这个数字同行:每次运行的赛道完全相同,只有起始姿态不同,所以这是关于泛化的弱证据;这是仿真,不是飞行;并且我们没有重新运行任何其他人的系统。在上游的决策节奏与延迟下(而不是瞬时决策),同一个地板完成了 10 次中 8 次,发生 6 次接触:节奏是有代价的。
7.3 · 靠先失败学会航线
计时赛是循环学习的地方。赛道被切成 6 米的区段,每段有一个速度上限和一个高度选择。每一轮在一个区段上提出一个动作(飞高、更快或更慢),从每个起点飞一遍,只有当 §3.7 的成本下降时才保留它;否则撤销,并把该动作的步长减半。记忆只存储每个区段的速度和高度,从不存储某个移动的缺口在哪里。学习期间会发生接触;每次接触计 15 秒,增加了接触的一轮会被丢弃。
从一个谨慎的初始方案出发,学习者从 39.4 秒、4 次接触降到 27.8 秒、0 次接触,在第 87 轮收敛;随后在没见过的起点上 10 次中 10 次干净飞完。在录制的飞行控制台中,学到的航线每一圈都以 27.6 秒、0 次接触完成。第二段录像从被清空的记忆开始:7 轮把成本从 69.39 降到 51.52,保留 2 项改动,撤销 5 项(图 10)。
7.4 · 失败了的学习者
失败的学习者和成功的那个一样属于记录的一部分。
- 逐段速度自适应(每 1 米一段,加性增、乘性减)在六圈内从 39.1 秒降到 20.9 秒,然后在第 7–20 圈崩溃。有两个站点在移动:在上游任何地方飞得更快,都会改变无人机遇到旋转门和滑动门的相位,而在失败点减速又会再次改变相位。逐段规则看不到这种耦合;在整轮上做接受/拒绝则可以。
- 一种减速修补——对每一次失败都以减速应对——连续 57 轮重复同一个动作、遭遇同一个失败。在这里更慢并不更安全:一架慢慢爬行的飞行器会以不同的相位遇到移动的站点。这就是一般形式的卡死规则:当同一个动作反复出现,它就是卡住了,必须脱出,而不是重新规划回到这个循环里。
7.5 · 学习者碰不到的东西
前向速度按固定的次序组合:先是学到的区段上限,然后是对路径上障碍物的停止距离限制,然后是上游的反射。由命题 6,后两者只能降低学到的计划所提议的速度。学习者改变的是无人机尝试什么;它永远不改变它飞行时所受的物理边界。这就是连续情形下的失效安全性质:这里的“可容许集合”是一个速度区间,地板根据当前深度图计算它的上端,学习者只在其内部选择。
8 · 为什么猜测永远不能成为事实
循环的定义性步骤验证说的是:由环境而不是模型决定一个动作是否奏效。同样的纪律也管辖知识。语言模型可以提议一个事实,或者建议往哪里看。只有当一个独立的、确定性的检查对照某个来源确认了它,一个事实才被接纳;而一个经过验证的事实要么完整、要么不存在,永远不会是“86% 正确”。当没有任何东西能验证时,答案是未知。本节解释为什么这条规则是二元的,以及我们故意打破它时发生了什么。我们只在性质层面描述接纳规则;事实如何被提取、如何做矛盾检查、如何连同出处被存储,不属于本文内容。
算术。设一个模型的每个猜测正确的概率为 \(q\),而一个答案依赖于 \(k\) 个被猜测的事实。若各猜测相互独立,答案保持正确的概率为 \(\Pr[\text{答案正确}]=q^k\);当 \(q=0.858\)、\(k=2\) 时,\(0.858^2\approx0.736\)。这只是一个示例,不是我们的分析,但它与我们测得的结果一致。
测量。任务是在 160 种人类激酶中、基于 2,775 个经过验证的特征,诊断性地识别一个隐藏目标,采用逐特征的成本模型:每一次测量询问目标是否具有特征 \(f\),经过验证的参考数据排除不一致的候选 [25]。在参考数据被遮蔽 40% 的情况下,一个强化过的、考虑成本的信息增益规划器需要 19.66 个成本单位,正确识别率为 1.000。一个没有真值权威的前沿语言模型预测了 44 个判别性特征中被遮蔽的 2,875 个条目,对照密封的真值,准确率为 85.8%,这是一个确实不错的先验。把它的猜测接纳进排除步骤后,平均成本从 19.66 降到 12.10(\(-38.4\%\),配对 90% 置信区间 \([6.65, 8.51]\)),而正确识别率从 1.000 降到 0.753。全部 39 次误识别都源于对真实目标自身被遮蔽条目的一次错误猜测:一个错误的单元格就排除了真正的答案,而且没有任何事实可以用来核对这个猜测。
| 线 | 平均成本 | 正确识别 | 结论 |
|---|---|---|---|
| 基线规划器,不填充 | 19.66 | 1.000 | 参照 |
| 模型猜测被当作事实接纳(准确率 85.8%) | 12.10 | 0.753 | 拒绝:破坏真值 |
| 模型为往哪里看排序,接纳受保护 | 18.86 | 1.000 | 拒绝:\(-4.06\%\),低于门槛 |
| 已验证卡片检索 | 11.50 | 1.000 | \(-41.5\%\),正确性完美 |
分解才是重点。在接纳线 38.4 个百分点的表面收益中,约 34 个是靠破坏真值换来的,约 4 个是先验对“下一步该问哪个问题”的正当贡献,这正是受保护线所测量的(4.06%,真实存在但低于预注册门槛)。把接纳限定为经过验证的事实、只让模型为往哪里看排序,使正确识别率保持在 1.000。一个 86% 时间正确的猜测,一旦被允许当作事实,仍然会在大约四次中破坏一次答案。
与先失败的联系。失败优先模型与失效安全模型在两个地方应用同一条规则。在动作一侧,只有经过验证的结果才成为证据:模型仅仅预测到的失败不会写下卡片。在知识一侧,只有经过验证的事实才被接纳:模型仅仅预测到的事实不会进入答案。在两个地方,模型都可以提议,而由某个它无法写入的东西来决定。这也是为什么学习的那一半可以放心地一直运行:它的教训关乎尝试哪个被允许的选项,永远不关乎什么是真的、什么是被允许的。
10 · 局限与开放问题
状态。研究原型。仅限仿真与游戏。这里没有任何东西飞过、驾驶过道路车辆,或经过安全关键路径的鉴定;“失效安全”指的是一种架构性质,而不是功能安全认证。每一个数据都是我们自己的,没有一个经过第三方复现。
风险即目标(开放)。当完成任务的动作恰恰就是让模型暴露于风险的动作时,单纯的失败规避会拒绝执行任务。Freeway 表明了这一点:三条规则,每一条都阻止 up,驾驶员正确地停止了得分。在效用排序之上加一个灾难性地板并没有修复它;它重建了最初的否决,并让两款游戏都变差。一个剩余回报排序达到了持平,并在使用到达时间签名时达到 \(+8\%\),但没有学会时机,而且它是一种排序而不是地板。一个为可恢复性而不是致命性定价的地板(拒绝无法撤销的事,允许其他一切,直至那条边缘)尚未建成。由 §3.8,一条正确的教训仍可能是代价高昂的。
模型必须失败才能学习。规则是由观察到的失败赢得的。在第一次失败就不可接受的地方,地板必须写出来,而不是学出来;那是经典的屏蔽情形,也是另一种产品定位。
组合需要设限。退役在重放的记忆上把死路从 6 条降到 0 条;它对游戏表现的影响尚未测量,也尚未在多个智能体之间的约束占主导的规模上得到展示。
过度泛化(开放)。分桶决定两个局面何时算“相同”;它在一处声明,并且是可争议的。拓宽一个模式可能会判禁一个从未尝试过的情境(§6.3 中的严格预期失败)。补救办法——在未尝试过的情境中探索被判禁的目标——尚未建成。
归因会无声地失败。我们自己的两个缺陷在被抓到之前产生了可信的曲线。定理 1 让一条归错了责任的规则无法扩大权限;它不能阻止这条规则让模型变得无用。
保证只在被钉住的地方主张。定理 1 是对 VDSG 主张的,在那里学习者的位置在代码中被强制执行并由测试钉住。在 Atari 原型中,失败记忆只移除动作,但其上方的参数搜索层(一个对驾驶员参数的进化搜索,它在密封种子上把一项改动从 103.0 提升到 221.8)会变异一个同时包含地板参数的参数向量,其中一次变异放松了其中一个。那里的地板参数与策略参数尚未分离,因此不对 Atari 原型主张这一保证。
小样本与弱泛化。Fallout 的结果是经由真实决策循环的脚本场景;无人机的留出起点只改变同一条赛道上的起始姿态;DOOM 关卡结果基于四到八次尝试;游戏运行时中唯一有统计功效的比较——32 个 DOOM 种子——是一个零结果。激酶任务只使用一个包含 160 个候选的冻结实例。
本文不公开的内容。以上所有内容要么是标准数学,要么是我们公开测量的性质。让 Peel 科学地板在规模上运作的机制——包括事实如何被提取、矛盾如何被否决、出处如何被存储,以及接纳门的内部检查——在专利审查期间暂不公开。它们被主张具有的性质已经陈述;它们的内部细节没有。
效度威胁。所有测量都由建造这些系统的同一团队完成。不同实验卡之间的基线不同,必须在一行之内比较。游戏便宜、确定、宽容,而物理世界不是;从游戏引擎到实际平台的迁移尚未经过测试。基于规则的驾驶员承担了大部分表现,而在有统计功效地测量的地方,学习层的贡献很小。
11 · 结论
一个从经验中学习的模型必须先失败。有用的问题是失败被允许通向哪里,而本文给出的答案是架构性的:在学习者运行之前,从学习者无法写入的来源和指令中计算出模型被允许做什么;只让经过验证的失败在该权限之内教导它;并把每一条教训保存为引用其背后失败的规则。这样,一次失败可以改变模型下一次尝试什么,却永远不能改变它被允许做什么;而这一点的证明只有一行,因为它取决于学习者所处的位置,而不是它有多好。
测量说明了这换来了什么、没换来什么。失败记忆在失败是终局性的地方有帮助(Space Invaders 上 \(+32\%\)),在有风险的动作是唯一有用动作的地方有害(Freeway 上 \(-12\%\))。各自正确的规则组合起来会导致瘫痪,除非让它们退役。归因是学习系统自欺的地方,而我们自欺了两次。好规则之上的学习层可能是一个零结果(\(t=0.78\))。在一个只会让它变慢的停止距离地板之下,一条航线可以在七轮内从零重新学会;而一个 86% 时间正确的猜测,一旦被允许当作事实,仍然会在四次中破坏一个答案。
失败优先,是模型学习的方式。失效安全,是这种学习永远不能改变的东西。开放问题是:在不给学习者扩大地板的权力的前提下,为可恢复的失败定价。
致谢
Atari 实验使用街机学习环境与 Stella 模拟器;DOOM 实验使用 ViZDoom 与 Freedoom;德军总部 3D 运行于 ECWolf;Fallout 运行于 Fallout Community Edition 引擎;无人机赛道与飞行器来自开源的 jev-drone 项目,我们未作修改地使用了它。我们感谢它们的作者。
参考文献
- M. Alshiekh, R. Bloem, R. Ehlers, B. Könighofer, S. Niekum, U. Topcu. Safe reinforcement learning via shielding. In Proc. AAAI Conference on Artificial Intelligence, 2018.
- E. Altman. Constrained Markov Decision Processes. Chapman & Hall/CRC, 1999.
- D. Amodei, C. Olah, J. Steinhardt, P. Christiano, J. Schulman, D. Mané. Concrete problems in AI safety. arXiv:1606.06565, 2016.
- M. G. Bellemare, Y. Naddaf, J. Veness, M. Bowling. The Arcade Learning Environment: an evaluation platform for general agents. Journal of Artificial Intelligence Research 47:253–279, 2013.
- M. Chen, Y. Li, Y. Yang, S. Yu, B. Lin, X. He. AutoManual: constructing instruction manuals by LLM agents via interactive environmental learning. In Advances in Neural Information Processing Systems (NeurIPS), 2024. arXiv:2405.16247.
- P. Compton, R. Jansen. A philosophical basis for knowledge acquisition. Knowledge Acquisition 2(3):241–257, 1990.
- R. Dechter. Constraint Processing. Morgan Kaufmann, 2003.
- J. García, F. Fernández. A comprehensive survey on safe reinforcement learning. Journal of Machine Learning Research 16:1437–1480, 2015.
- K. J. Hammond. CHEF: a model of case-based planning. In Proc. AAAI-86, 1986.
- R. M. Haralick, G. L. Elliott. Increasing tree search efficiency for constraint satisfaction problems. Artificial Intelligence 14(3):263–313, 1980.
- Z. Ji et al. Survey of hallucination in natural language generation. ACM Computing Surveys 55(12), 2023.
- jev-drone。开源无人机仿真项目,github.com/RomanSlack/jev-drone;在提交
974b473处未作修改地使用。 - M. Kempka, M. Wydmuch, G. Runc, J. Toczek, W. Jaśkowski. ViZDoom: a Doom-based AI research platform for visual reinforcement learning. In IEEE Conference on Computational Intelligence and Games, 2016.
- V. Krakovna et al. Specification gaming: the flip side of AI ingenuity. DeepMind blog, 2020.
- J. P. Marques-Silva, K. A. Sakallah. GRASP: a search algorithm for propositional satisfiability. IEEE Transactions on Computers 48(5):506–521, 1999.
- S. Minton. Learning Search Control Knowledge: An Explanation-Based Approach. Kluwer, 1988.
- L. Sha. Using simplicity to control complexity. IEEE Software 18(4):20–28, 2001.
- N. Shinn, F. Cassano, E. Berman, A. Gopinath, K. Narasimhan, S. Yao. Reflexion: language agents with verbal reinforcement learning. In Advances in Neural Information Processing Systems (NeurIPS), 2023. arXiv:2303.11366.
- S. S. Shperberg, B. Liu, P. Stone. Learning a shield from catastrophic action effects: never repeat the same mistake. arXiv:2202.09516, 2022.
- S. S. Shperberg, B. Liu, A. Allievi, P. Stone. A rule-based shield: accumulating safety rules from catastrophic action effects. In Proc. 1st Conference on Lifelong Learning Agents (CoLLAs), PMLR 199:231–242, 2022.
- E. Todorov, T. Erez, Y. Tassa. MuJoCo: a physics engine for model-based control. In IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2012.
- E. B. Wilson. Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association 22(158):209–212, 1927.
- A. Zhao, D. Huang, Q. Xu, M. Lin, Y.-J. Liu, G. Huang. ExpeL: LLM agents are experiential learners. In Proc. AAAI Conference on Artificial Intelligence, 2024. arXiv:2308.10144.
- Perslis Research. VDSG: a commanded admission-control runtime for autonomous agents. Systems paper, 2026. research.perslis.com/vdsg.html
- Perslis Research. Inference placement: where learned inference earns authority in a symbolic system. Preprint, 2026. research.perslis.com/inference-placement.html
- Perslis Research. What is a fail-safe model? Definition, science and math. 2026. perslis.com/fail-safe-model
- Perslis Research. Fail-first models: failure becomes structure (the arcade floor, frozen result). 2026. perslis.com/research/arcade
附录 A · 每个数字的来源
本文中的每一个数字都取自一张冻结的实验卡、一篇已发布的 Perslis 页面或论文,或者在写作期间以只读方式重新运行的测量。对该模型的公开解释见 [26];已发布的冻结 Atari 结果见 [27]。
| 结果 | 来源 |
|---|---|
| Space Invaders 与 Freeway(V1)、学习曲线、54 条规则的崩溃、五个缺陷、Freeway 规则 | 冻结卡 ARCADE-FLOOR-V1(标签 freeze/arcade-floor-2026-09-25);公开的街机页面 [27] |
| V2、V2.1、V2.2 实验组与代价扫描 | 冻结卡 ARCADE-FLOOR-V2(引用 V1;V1 未编辑) |
| 死路与被迫局面(30 / 50 / 退役后),交还的 29 次失败 | 退役重放,于 2026-09-27 以只读方式重新运行(4,320 个决策,91 个局面) |
| 4,280 张卡片 → 30 条规则 → 203 个瓦片;示例否决 | Space Invaders 记忆的瓦片追溯构建;公开的证据章节 |
| DOOM 竞技场各实验组与配对统计 | 冻结卡 DOOM-FLOOR-V1 |
| DOOM 与德军总部关卡结果、击杀计数器缺陷、轨迹规则 | VDSG 论文 [24],§§5–9 |
| Fallout:49 次死亡、根本原因、脚本场景、测试数量 | VDSG 失效安全章节(2026-09-26 发布);四个边界测试于 2026-09-27 重新运行;收集到的测试数量取自同一天 |
| 无人机:10/10 对 1/10、航线学习、重新学习 69.39 → 51.52、失败的学习者 | 飞行演示页面;无人机线的证据与航线记忆源代码;录制的控制台 |
| 激酶任务 | Inference Placement 预印本 [25] |
| Wilson 界、\(q^k\)、\(p\lt v/(v+c)\) | 由 §3 中的公式计算 |
图。图 1 是 Perslis 失败优先信息图。图 9 与图 10 是从录制的完整控制台中提取的单帧(DOOM 帧取自 8 秒处,在一个措辞早于现行表述的标题下方裁切;无人机帧取自 170 秒处,属于清空记忆后的重新学习)。其余所有图都由其所附表格中的数字绘制。在这个网页版中,图 2–8 按与 PDF 相同的数字重新绘制;图 9 只展示控制台的左侧面板。
如何引用
Perslis Research. Fail-First Models. Research prototype, September 2026. https://research.perslis.com/fail-first
(论文原文为英文;请引用英文标题。)
@techreport{perslis2026failfirst,
  title       = {Fail-First Models: Failure Becomes Structure},
  author      = {{Perslis Research}},
  institution = {Perslis Research},
  year        = {2026},
  month       = {9},
  note        = {Research prototype; simulation and games; not a certified safety system.},
  url         = {https://research.perslis.com/fail-first}
}