AI 系统 · 含回放取证的实证研究 · 研究原型(仿真与游戏)
方向盘上的规则
坦克、语言模型与一场诚实的失败。在 Atari BattleZone 与 BZFlag 中测量规则驾驶员:对照简单基线、三个语言模型驾驶员和游戏引擎自带的 AI——以及说明引擎 AI 为何获胜的那段回放。
我们在两款坦克游戏中测量规则驾驶员(按优先级排列的规则,在做决策的环节中没有神经网络),并报告每一项比较,包括我们输掉的那一项。在 Atari 2600 BattleZone 中,只读取屏幕,驾驶员在十个种子上的平均得分为 27,000,随机操作为 3,000,去掉扳机为 0;一条依据 25 次有记录的死亡和 403 次回放的炮弹事件构建的闪避规则在验证中被否决(24,800 对 28,000)。在每个驾驶员都读取同一份引擎状态的 3D 自由混战游戏 BZFlag 中,十分钟主赛(一场比赛)的结果是:BZFlag 自带的 AI 38–6,我们的规则 20–20,DeepSeek 10–18(每次决策 1.0 秒),经命令行接口的 Claude 1–15(每次决策 7.6 秒;这是传输方式的限制,不是对模型的测量),llama3.2:3b 0–10。没有时间压力时,规则通过 8 道考题中的 8 道,Claude 6 道,DeepSeek 5 道。在 38 场计入的比赛中(7 次运行被排除并列明原因),引擎 AI 在每一场对等对抗中都击败了我们的规则。对每次死亡前最后两秒的回放说明了原因:在一场比赛中,我们 27 次有回放的死亡里有 16 次是闪避规则中位提前 1.2 秒标记了致命炮弹,随后又在自己 4 米走廊的边缘中位松手 9 次;引擎的 15 次死亡中有 13 次是在视野中不到 0.5 秒的炮弹。单个数据包的判读曾把我们的大多数死亡称为“闪避太晚”。更宽的走廊此后晋升,在它唯一一场对等对抗中仍然落败,差距如今在进攻端。
击败这些语言模型驾驶员,不需要在决策环节中放一个神经网络。要击败引擎,需要比我们更好的规则。
问题。坦克实时交战的电子游戏,是检验决策者的一个便宜、公平又毫不留情的考场。我们让三类驾驶员驾驶同样的坦克:一小份我们手写的规则;三个 AI 语言模型(Claude、DeepSeek,以及在同一台电脑上运行的小型 Llama);以及游戏自带的电脑玩家——它不是我们写的。
结果。我们的规则击败了全部三个语言模型——六场中的五场,以及总体。我们能看到的主要原因是时间:我们的规则每秒决策约一百次,而在主赛中,模型每次决策要花一到八秒,而一枚炮弹一秒钟就能飞过一百米。但是,游戏自带的电脑玩家击败了我们的规则——每一次双方在对等条件下相遇,都是明确的失利。
为什么这很重要。输给游戏自带的玩家,比赢了语言模型告诉我们的更多。我们对这场失败的第一个解释是错的。通过回放每次死亡前的最后两秒,我们找到了真正的原因:我们的坦克提前一秒多就看到了致命的炮弹,也开始闪避,却在自己安全区的边缘一次又一次地松开闪避,又漂回炮弹的弹道附近。游戏自带的玩家则大多死于任何人都躲不开的炮弹。
它不是什么。它不是产品,不是“规则普遍胜过 AI”的论断,也不是对 Claude 水平的测量:在测试机器上接入 Claude 的唯一方式是一条很慢的命令行通道。这里的一切都是游戏中的研究原型,数字都是小样本,并如实标明。
1 · 引言
实时游戏是一个便宜、可重复、毫不留情的场所,用来追问一个决策者究竟值多少。坦克不会等驾驶员想完,分数由游戏而不是实验者记录,而每一局都可以录下来。本文向一类驾驶员提出三个问题,这类驾驶员是规则驾驶员:一小份显式规则,最紧急的排在最前,把驾驶员感知到的情况变成一个动作,做决策的环节中没有神经网络。
- Q1.它是否好过“什么有用的事都不做”?我们把它与随机操作、以及去掉扳机的同一驾驶员相比。
- Q2.它是否好过拿到同样事实的语言模型?我们给 Claude、DeepSeek 和一个小型本地 Llama 同样的局面、提示词、输出结构和伺服器,让它们在同一场比赛里各自驾驶一辆坦克。
- Q3.它是否好过游戏自带、由游戏开发者编写和调校的 AI?如果不是,我们能否用证据而不是猜测说明原因?
答案是:是、是、否。第三个答案是本文最有用的内容。在 BZFlag 中,引擎自带的 AI 在有语言模型参加的六场比赛中场场击败我们的规则,在双方单独以相同数量相遇的全部九场比赛中也都击败了我们的规则,而我们自己的工具对这场失败给出的第一个解释是错的。我们报告它错在哪里、取而代之的回放分析,以及回放说明了什么:我们的驾驶员大多死于提前一秒多就看到、也开始闪避的炮弹,却在自己闪避走廊的边缘放弃了闪避;引擎 AI 大多死于它不可能及时看到的炮弹。
我们做了什么
第一款游戏是 Arcade Learning Environment 中的 Atari 2600 BattleZone [4], [9]。驾驶员用数组运算读取 210 × 160 屏幕上的两个区域,从不读取模拟器的内存。第二款是开源 3D 坦克游戏 BZFlag [6],其中每辆坦克都是一个独立的游戏客户端,配有各自的驾驶员:我们的规则、三个语言模型,以及 BZFlag 自带的 AI。对客户端的一个小补丁把每辆坦克的操控交给一个外部进程,并每帧传给它一个状态数据包;同一个数据包供给我们编写的每一个驾驶员,而 BZFlag 的 AI 运行的是未经修改的上游代码。每一场比赛都有录像,每一场被排除的比赛都列出原因。两款游戏中驾驶员感知的东西不同:BattleZone 中是像素;BZFlag 中是引擎自身的状态,另有一个单独的图像检查(见其专文 [18])只能扣住一发炮弹,不能发起动作。
贡献
- 一个只看像素的规则驾驶员,连同它的基线和一条被否决的规则(§3)。在 BattleZone 中,在同样的十个种子上,驾驶员得分 27,000,随机操作 3,000,去掉扳机为 0。一条依据 25 个死亡窗口和 403 次回放炮弹事件构建的闪避规则在验证中落败(24,800 对 28,000)并被否决;我们把这次否决作为一项结果报告。
- 一个让规则、语言模型和游戏自带 AI 同场可比的竞技场(§§4–5)。同样的事实、同一个提示词、同一个结构、同一个解析器、同一个伺服器;失败的调用被计数,从不被掩盖;每场比赛都有录像;38 场计入比赛和 7 次被排除的运行,每一次都有理由。主赛只是一场比赛,凡是用到它的地方我们都这样说明。
- 一次失败的、经回放证实的解释(§6)。每次死亡前两秒的数据包都会用每一条候选闪避规则重放一遍。在观察比赛中,我们 27 次有回放的死亡里有 16 次是在走廊边缘放弃的闪避;引擎的 15 次死亡中有 13 次是在视野中不到半秒的炮弹。我们说明单个数据包的判读为何误判了我们的死因,以及驾驶员自己的学习循环为何没有更早找到原因。
- 一个经过测量的开火门控(§7)。见证门控开启时,重点比赛中 75 发炮弹里 0 发是盲射;门控的代价是一次近身遭遇,其间它连续扣住开火十二次。
我们主张什么,不主张什么
我们主张上述测量结果,并在每一项旁边写明样本量。我们不主张规则普遍优于学习到的策略,不主张我们的驾驶员在任一款游戏中玩得好,也不主张语言模型的结果测量了模型本身:在测试机器上接入 Claude 的唯一途径是一个每次决策都要重新启动的命令行接口(§4.5),而 Llama 坦克运行的是在同一台机器上本地运行的约三十亿参数模型。这里的任何内容都尚未被第三方复现。§6 中的学习循环在数据冻结时仍在运行;我们报告的是它在截止点的状态,包括哪些尚未证实。
2 · 术语、度量与记录
规则驾驶员。一个从感知到的局面映射到一个游戏动作的函数,写成一份有序的规则列表。第一条条件成立的规则做出决定;每次决策都返回动作、触发的规则和一句理由,因此记录显示了每个动作为何被采取。规则中没有任何拟合出来的参数。在 BattleZone 中,局面从屏幕读取(§3);在 BZFlag 中,局面是每个驾驶员都会收到的引擎状态数据包(§4)。“决策环节中没有神经网络”的确切含义是:没有任何学习得到的组件去选择或排序动作。语言模型驾驶员当然是神经网络;它们正是规则的比较对象。§7 中的见证检查是学习得到的,但它只能扣住一发炮弹,从不选择动作。
度量。BattleZone 自己记分,而且只有玩家摧毁了什么东西,分数才会上升。在 BZFlag 中,每辆坦克都是其他所有坦克的敌人(自由混战);我们报告每辆坦克的击杀与阵亡、二者之比(K/D)、每坦克·分钟的击杀,以及学习循环自身所优化的每坦克·分钟净得分(击杀 − 阵亡)。模型的决策时间是从发出局面到收到回复的墙钟时间,失败的调用也计算在内。
记录。每场 BZFlag 比赛都会写下一段观战录像、每 10 秒一次的计分板、最终结果,以及每辆坦克的黑匣子。黑匣子的内容在当天逐步扩充:最早几场比赛保存了每一次模型决策(局面、回复、延迟)和每辆坦克每秒一次的采样;后来的比赛又加入了每辆坦克自己的视角、每一次规则决策、每一发炮弹和每一次扣住的开火,并且自 9 月 27 日 00:15 起,每次死亡都附带死亡前最后两秒的数据包。我们只读取 JSON 文件;没有任何数字是从录像中得出的。一场比赛满足以下条件才计入:写完了结果、至少进行了 1.5 分钟、至少有两类驾驶员参加,并且没有一个说明其前提已被破坏的 INVALID.md 文件。被排除的运行都列在表 7中,绝不悄悄丢弃。
截止点。撰写本文期间,BZFlag 学习循环(§6.7)仍在为另一个会话运行。我们把数据冻结在 2026 年 9 月 27 日 01:05:50(美国东部夏令时)结束的那场比赛(运行 20260927-010140):自 9 月 26 日 18:11 起共 45 个运行目录。此后记录的任何内容都没有使用。分析脚本以固定的提交版本导入各条实验线自己的分析代码,因此之后对这些代码的修改不会改变我们的数字(附录 A)。
3 · 只看像素的 BattleZone
3.1 · 设置
Atari 2600 BattleZone 运行在 Arcade Learning Environment [4], [9] 中,软件包 ale_py 0.11.2,环境为 ALE/BattleZone-v5。v5 环境以 0.25 的概率重复上一个动作(“粘滞动作” [9]),这使固定的动作序列不会重放同一局游戏。驾驶员每 4 帧决策一次,即每秒游戏时间决策 15 次,可以使用全部 18 个摇杆动作。一局在游戏结束(五条命)或 30,000 帧时结束;这个上限从未起作用。每组都玩种子 0–9,各组使用相同的种子。两条基线把驾驶员夹在中间:随机,即每次决策在 18 个动作中均匀随机选择;不开火,即去掉扳机的同一驾驶员。由于游戏分数只有在玩家摧毁东西时才会上升,不开火组的得分必须恰好为零;它出现在每一张表里,用来说明分数是驾驶员自己挣来的。
3.2 · 眼睛
驾驶员从不读取模拟器的内存。它用数组运算读取原始 210 × 160 RGB 画面中的两个区域(表 1)。在写下任何规则之前,先在运行中的游戏上测量了两个事实:雷达扫描线是一条虚线射线(隔行出现的 2 像素短划,每个角度保持约 4 帧),因此接触雷达中心的连通块、或同一射线上的两个及以上连通块属于扫描线,孤立的点才是敌人;向右转会让视野中的物体和雷达光点都向左移动,速度约为每帧 0.9 像素和约 1°,这确定了每一次转向的正负号。
| 区域 | 位置(行、列) | 读取什么、如何读取 |
|---|---|---|
| 雷达 | y 3–35,x 74–95;中心 (19, 84) | 白色连通块;去掉接触中心的,以及同一射线上(9° 以内)两个及以上的;孤立的点就是光点:方位(0 = 正前方)与距离比例 |
| 地面带 | y 96–138;x ≥ 8 | 每一行都是一种纯色,因此偏离该行颜色的像素属于某个物体;二维连通块;不超过 16 像素、5 行的连通块是炮弹 |
| 瞄准线 | 第 x = 78 列 | 瞄准误差是物体所在列与瞄准线之间的偏移 |
3.3 · 驾驶员
三条规则,最紧急的在前。ENGAGE(交战):地面带中有一个至少 20 像素的物体;朝它转向,当它距瞄准线 3 像素以内时开火(8 像素以内时边转边开火)。2600 要求两次开火之间松开按钮,所以驾驶员最多每隔一次决策开火一次。HUNT(追猎):雷达上有光点(记住 8 次决策,因为扫描线可能把它遮住);光点在正前方 10° 以内时朝它驶去,在身后时原地转向,其余情况边开边转。SEARCH(搜索):一无所知时,每 60 次决策中前进 40 次,向右扫视 20 次。
3.4 · 结果
| 组别(种子 0–9) | 平均得分 | 标准差 | 中位数 | 范围 | 每局击杀 |
|---|---|---|---|---|---|
| 随机 | 3,000 | 3,590 | 1,500 | 0–12,000 | 0–6 |
| 不开火 | 0 | 0 | 0 | 0–0 | 0 |
| 规则 | 27,000 | 8,380 | 23,500 | 15,000–44,000 | 15–35 |
规则驾驶员的平均得分为 27,000(标准差 8,380),随机操作为 3,000(标准差 3,590),不开火为 0(表 2,图 1)。ENGAGE 做出了驾驶员 69.8% 的决策,HUNT 26.6%,SEARCH 3.6%。每一局最后仍然是五条命全部丢光,历时 1.5 到 2.8 分钟游戏时间。
这是背景,不是比较。Mnih 等人报告的 BattleZone 得分为:随机 2,360,职业人类测试员 37,800,DQN 26,300(±7,725) [10,扩展数据表 2]。他们的评估协议在每个关键维度上都与我们不同:30 个最长五分钟的评估回合,开局最多 30 个空操作,ε = 0.05 的 ε-贪心策略,没有粘滞动作,随机智能体以 10 Hz 行动;人类得分是约两小时练习后约 20 个五分钟回合的平均。众所周知,ALE 上的评估协议会显著改变分数 [9]。粗略地说,规则落在 2015 年 DQN 智能体的范围内,低于人类参考值;后来的深度强化学习智能体在全部 57 款 ALE 游戏上都超过了人类参考值 [3]。这个驾驶员与最先进水平没有可比性,它本来也不是为此设计的。
3.5 · 从死亡中学习,以及一条被否决的规则
既然每一局都以游戏结束告终,下一步就是研究死亡。一次取证记录了种子 0–4 中 25 次死亡各自之前的最后 30 次决策和最后 12 帧画面(图 2)。人工判读:约八次死亡能看到敌方炮弹从屏幕上方落下,约八次是炮弹位于驾驶员正在射击的那辆坦克所在的列中,约七次看不出原因;这些计数是对画面条带的粗略判读,不是分类器的输出。第二种模式暴露了一个缺陷:眼睛按列的连续段来归并地面带,所以炮弹在它自己那辆坦克下方时,会与坦克合并成一个物体。眼睛现在改用二维连通块,并单独标出炮弹。
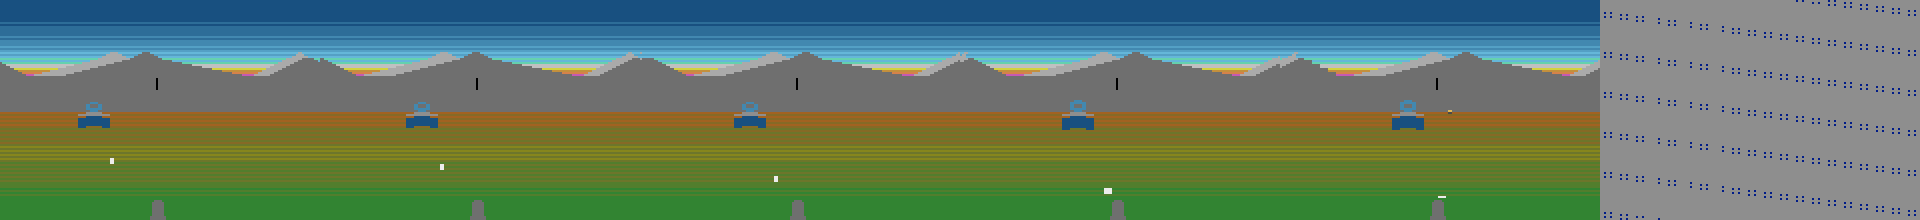
为了用实验而不是直觉来选择闪避方式,一个离线的闪避实验台在每一次来袭炮弹时给模拟器存档,并从同一时刻重放九种候选闪避动作,每种保持 6 次决策,之后再执行 25 次普通规则决策。实验台把模拟器的存档当作“先知”使用,而驾驶员在实战中从不这样做。它在关闭粘滞动作的情况下运行,以便恢复的状态能精确重放。它的第一次运行是无效的:关闭粘滞动作后游戏是确定性的,所有种子重放的都是同一局;改用不同数量的开局空操作(每个种子 1 到 60 个)后解决了这个问题。表 3 给出了关键的条件结果:在普通规则会死亡的 41 个事件中,向前开救下了 9 个。
| 保持 6 次决策的闪避动作 | 存活,全部 403 个事件 | 救下,规则会输的 41 个中 |
|---|---|---|
| 向前 | 369 (91.6%) | 9 |
| 倒车 | 356 | 7 |
| 转向炮弹一侧 | 360 | 4 |
| 向前 + 转向炮弹一侧 | 362 | 4 |
| 不闪避(普通规则) | 362 (89.8%) | 0 |
| 转离炮弹;倒车 + 任一方向转向;向前 + 转离 | 348–351 | 0 |
随后,一条 DODGE 规则(发现炮弹从屏幕上方落下时向前开 6 次决策)在正常协议下接受验证。在改进后的眼睛下,驾驶员不带 DODGE 得分 28,000(标准差 6,055),带 DODGE 得分 24,800(标准差 8,600)(图 1,右)。逐个种子比较,DODGE 有 3 个更高、6 个更低、1 个持平;配对差值为 −3,200,\(t(9) = -0.94\)。在十个种子下这一损失并不显著,但看不到任何收益的迹象,而且 DODGE 占去了全部决策的 21.8%,这些决策本来用于瞄准。这条规则被否决;驾驶员发布时不带它,而这一组仍保留在测试框架中,以便重复测量。仅改进眼睛就让得分从 27,000 升到 28,000,这在噪声范围之内(Welch \(t = 0.31\))。两组中的每一局仍然都以游戏结束告终。
这次否决说明了什么。一条规则可以被它自己的证据证明是正确的,却仍然会输。向前开比其他任何闪避动作躲过了更多炮弹,却仍然让分数损失得比它挽回的更多,因为证据测量的是存活,而游戏衡量的是摧毁。同样的教训——局部正确的规则在全局上可能是错的——正是失败优先论文中的 Freeway 结果 [15];这里,验证步骤在规则发布之前就发现了它。
4 · BZFlag 竞技场
4.1 · 游戏与服务器
BZFlag 是一款开源多人 3D 坦克游戏 [6];我们在上游提交 4299415 处从源码构建了它。服务器以自由混战模式运行,每辆坦克最多有两发炮弹同时在飞(-ms 2),世界由服务器以建筑密度 3 自动生成。没有世界文件时,服务器会生成一个以时钟为种子的随机世界,因此每一场比赛都在一个新的随机布局上进行,箱体和金字塔的位置各不相同(未启用传送门);同一场比赛中所有坦克共享这个布局。引擎的默认值决定了每个驾驶员所处的物理规律:炮弹以 100 米/秒飞行,350 米后消失(因此坦克的装填时间为 3.5 秒);坦克长 6.0 米、宽 2.8 米,最高速度 25 米/秒,每秒最多转 45°。
4.2 · 客户端里的一个接口,以及原封不动的引擎 AI
一个小补丁(FloorLink)只在设置环境变量时启用,它让客户端的自动驾驶把决策交给一个外部进程。每一帧,客户端发送一个 JSON 数据包,内容是坦克自身的位姿、敌方坦克的距离、方位和是否有无遮挡的视线、200 米以内且在一个坦克高度范围内的在飞炮弹,以及八个方位上的开阔距离;客户端执行它收到的最新指令(转向速率、速度、开火)。如果一秒内没有收到指令,客户端自带的 AI 会接管——语言模型坦克除外,它们被设为停车,这样 BZFlag 的 AI 就永远不可能悄悄替模型驾驶坦克。BZFlag 自带的 AI 是未经修改的上游 AutoPilot 代码:补丁只在它开头加了一个五行的挂钩,别无其他。这个 AI 会闪避 100 米以内、以约 16° 以内角度朝它飞来的最危险的炮弹,蛇形逼近目标,在 50 米以内且可以开火时后退,为目标预留 0.3 秒的提前量,并在瞄准误差很小且视线无遮挡时开火。它在客户端内部每帧运行,没有任何传输延迟;我们的控制器通过本地套接字应答,所以它们的指令会在稍后的一帧才到达坦克。
4.3 · 驾驶员
| 坦克 | 驾驶员 | 通道 | 决策频率 |
|---|---|---|---|
| floor-rules | 我们的规则驾驶员(模型比赛中为 v1) | 本地 UDP,每帧 | 约每秒 100 次 |
| claude-opus5 | Claude,模型标识 claude-opus-5,effort 设为 “low” | claude -p 命令行接口(机器上没有 API 密钥) | 按自己的节奏 |
| deepseek-chat | DeepSeek deepseek-chat | HTTPS API,JSON 模式,temperature 0 | 按自己的节奏 |
| ollama-llama3b | Llama 3.2,3B(llama3.2:3b) | 本地 Ollama,以结构作为输出格式,temperature 0 | 按自己的节奏 |
| bzflag-autopilot | BZFlag 自带的 AI | 在客户端内部,上游代码 | 每帧 |
规则驾驶员。参加模型比赛的第 1 版有四条规则,最紧急的在前。DODGE(闪避):一发炮弹的直线弹道从坦克 4 米以内经过,并在 1.2 秒内到达最近点;横穿它的弹道,向坦克已经所在的那一侧驶离。ENGAGE(交战):射程内有一个视线无遮挡的敌人;瞄准炮弹到达时它将在的位置,当提前量点与瞄准线相差约一个车宽以内时开火,然后偏离敌人的火线 60° 持续一秒(“规避机动”)。HUNT(追猎):转向最近的敌人并前进,前方 12 米内有墙时绕向最开阔的方位。EXPLORE(探索):朝最开阔的方位行驶。第 2 版在 DODGE 之后加入了 UNSTICK(脱困)规则(§5.5),并让规避机动和闪避优先选择有开阔空间的一侧。学习循环的候选版本都是在第 2 版的基础上只改动一个有名字的行为(§6.7)。
4.4 · 公平性约定
- 同样的事实。我们编写的每个驾驶员都读取同一个数据包。模型收到的是一份紧凑的局面报告:最多五个最近的敌人,附距离、方位以及是否有清晰的射击线;最多五发来袭炮弹,附距离、方位以及是否正朝坦克飞来;八个方位上的开阔空间;以及坦克有多久没有移动。规则读取的是同样的字段。
- 每个模型同一个接口。同一个系统提示词、同一个 JSON 输出结构(在服务商提供结构化输出模式时使用该模式)、同一个解析器。模型决定转多少、开多快,以及是现在开火、转完再开火,还是不开火。
- 只负责执行的伺服器。在两次决策之间,伺服器执行模型的最后一条指令:按模型要求的角度转动坦克(相对于模型看到时的航向),如果模型说“转完再开火”,就在到达该航向时开火一次。它从不选择目标,也从不闪避。
- 失败不被掩盖。失败、过慢或无法解析的调用会让坦克继续执行上一条指令,并被计数。
- 不在过时状态上做决策。模型永远不会被问及超过 1.5 秒的旧局面。这一保护是在第一场十分钟比赛之后加入的:那场比赛中,Claude 坦克的客户端在约十秒后离开了游戏,而它的驾驶员在冻结的最后一个数据包上继续“决策”了十分钟(表 7)。
- 见证门控只约束我们运行的驾驶员。见证开火开启时(§7),我们的规则和模型坦克只向眼睛确认的敌人开火;BZFlag 的 AI 从不查询它。
4.5 · Claude 的传输通道
5 · 竞技场中的结果
5.1 · 主赛
主赛是比赛 20260926-183228:十分钟(实际进行 9.92 分钟),五辆坦克,每个驾驶员一辆,于 9 月 26 日 18:32:35 开始。五辆坦克全程在场(每辆 60,140–68,231 个状态数据包,没有客户端重启)。比赛中的每一次击杀都是另一辆坦克的一次阵亡:各 69 次。
| 坦克 | 击杀 | 阵亡 | K/D | 每分钟击杀 | 决策次数 | 决策时间中位数 | 失败调用 |
|---|---|---|---|---|---|---|---|
| BZFlag AI | 38 | 6 | 6.33 | 3.83 | 每帧 | 在客户端内部 | – |
| 我们的规则(v1) | 20 | 20 | 1.00 | 2.02 | 60,140 | 约 0.01 秒(每帧) | – |
| DeepSeek | 10 | 18 | 0.56 | 1.01 | 415 | 1.01 秒 | 2(另有 12 次无法解析) |
| Claude(命令行) | 1 | 15 | 0.07 | 0.10 | 58 | 7.55 秒 | 1 |
| llama3.2:3b | 0 | 10 | 0.00 | 0.00 | 213 | 2.55 秒 | 0 |
表 5 和图 3 中的排序就是结果:BZFlag 的 AI 以大幅优势居首,我们的规则第二,然后是 DeepSeek、Claude 和 llama3.2:3b。我们的规则击败了每一个语言模型,自己却被引擎 AI 击败——后者的击杀几乎是我们的两倍,阵亡不到我们的三分之一。
5.2 · 一次决策的代价
每个模型都按自己的节奏决策。在主赛中,规则做了 60,140 次决策,DeepSeek 415 次,llama3.2:3b 213 次,Claude 58 次:规则的决策次数约为最快模型的 145 倍。图 4 按决策频率和击杀频率标出了每一场计入的模型比赛中的每一辆坦克。各组的位置在比赛之间没有移动:在四场较长的比赛中(实际进行 5.9–9.9 分钟),Claude 的决策时间中位数为 7.53–9.47 秒(在两场较短的早期比赛中为 12.78 和 16.29 秒),DeepSeek 为 1.01–1.12 秒(2.97 和 5.29 秒),llama3.2:3b 为 2.55–3.96 秒(1.66 和 2.36 秒)。
5.3 · 考试:没有时间压力的同一批模型
竞技场把判断与速度混在一起。驾驶考试把两者分开:八个手工构造的局面,每个都是一个真实的状态数据包,都有客观正确的答案(敌人在左;在右;在正前方;来自侧面的炮弹;迎面而来的炮弹;敌人在建筑后面且前方有墙;周围什么也没有;敌人在正后方),作答时没有任何计时。模型下达的是转向角度,伺服器会在它下一次决策之前盲目地执行这个角度,因此考试对角度评分;规则则持续转动直到对准,因此对规则只评判方向。
| 驾驶员 | 答对(共 8 题) | 决策时间中位数 |
|---|---|---|
| 我们的规则 | 8 | 即时 |
| Claude claude-opus-5(命令行,JSON 结构选项) | 6 | 24.0 秒 |
| DeepSeek deepseek-chat | 5 | 6.2 秒 |
| Llama llama3.2:3b | 4 | 1.45 秒 |
| Qwen qwen2.5-coder:7b | 3 | 3.0 秒 |
| Mistral mistral:7b-instruct | 2 | 3.7 秒 |
Claude 在考试中是最好的模型(8 题中答对 6 题),在竞技场中却是倒数第二。关于小型本地模型要提醒一点:llama3.2:3b 对全部八个局面给出了几乎相同的答案(转完再开火、半速、向右转 10° 到 30°),Mistral 则总是向右转;llama 答对的四题,来自这个几乎不变的答案恰好能满足的评分标准。这次考试规模很小,它只测量驾驶员是否知道该做什么。
5.4 · 随时间推移:每一场计入的比赛
到截止点共记录了 45 个运行目录。有三十八场比赛计入:192 分钟的比赛,其中六场为模型阵容,三十二场只有规则和 BZFlag 的 AI。有七次运行被排除(表 7)。
| 运行 | 实际进行 | 排除原因 |
|---|---|---|
| 20260926-182000 | 9.9 分钟 | INVALID.md:Claude 坦克的客户端在约 10 秒后离开(该运行的说明认为可能原因是 macOS 的 OpenGL 转 Metal 层崩溃);它的驾驶员在冻结的最后一个数据包上继续决策了十分钟。由此加入了客户端监管和 1.5 秒的过时状态保护。 |
| 20260926-191409 | 0.3 分钟 | 短于 1.5 分钟 |
| 20260926-192915 | 9.9 分钟 | INVALID.md:眼睛的训练在承载控制器的同一个进程中运行,使控制器得不到算力(我们的规则打出 9–21,而此前两场为 15–10 和 13–11);此后训练移到了独立进程 |
| 20260926-214830 | 0.8 分钟 | 短于 1.5 分钟 |
| 20260926-221854 | 0.8 分钟 | 短于 1.5 分钟 |
| 20260926-224233 | 0.8 分钟 | 短于 1.5 分钟 |
| 20260927-002751 | – | INVALID.md:比赛开始时学习循环被移交给新代码,比赛中止;没有结果 |
| 驾驶员类别 | 6 场模型比赛(各 32.3 坦克·分钟) | 全部 38 场计入的比赛 | ||||
|---|---|---|---|---|---|---|
| 击杀–阵亡 | K/D | 每分钟击杀 | 击杀–阵亡 | K/D | 坦克·分钟 | |
| BZFlag AI | 113–18 | 6.28 | 3.50 | 1,278–730 | 1.75 | 442.1 |
| 我们的规则 | 65–57 | 1.14 | 2.01 | 629–1,024 | 0.61 | 442.1 |
| 候选规则(A/B) | – | – | – | 249–278 | 0.90 | 139.5 |
| DeepSeek | 29–55 | 0.53 | 0.90 | 29–55 | 0.53 | 32.3 |
| Claude(命令行) | 3–47 | 0.06 | 0.09 | 3–47 | 0.06 | 32.3 |
| llama3.2:3b | 2–32 | 0.06 | 0.06 | 2–32 | 0.06 | 32.3 |
在模型比赛中,我们的规则在六场中的五场里 K/D 高于每一个模型。例外是第一场,只有 1.9 分钟,规则打出 1–5,而 DeepSeek 为 1–1,Claude 为 1–2。BZFlag 的 AI 在全部六场模型比赛中 K/D 最高;在只有规则的比赛里,直到学习循环晋升了新驾驶员为止(前 29 场计入的比赛),它也场场最高。在晋升之后的九场计入比赛中,有五场是某个规则类别(新驾驶员或其候选)的 K/D 高于 BZFlag 的 AI;这五场全是 A/B 比赛,六辆坦克中有四辆是我们的,因此我们的许多击杀和阵亡发生在自己的坦克之间。在这一时期唯一一场对等对抗中,BZFlag 的 AI 仍然获胜(§6.7)。图 5 显示了每一场计入的比赛。
5.5 · 脱困规则
最早几场有记录的比赛没有记录位置,而录像显示坦克被卡在墙边。从那以后,每辆坦克都会得到同样的两个事实,对所有驾驶员以同样方式计算:它有多久没有真正移动(2 秒内移动不到 1.5 米),以及它移动了多远。驾驶员 v2 加入了 UNSTICK 规则:卡住 0.8 秒后,一边前进一边向更开阔的一侧转 1.2 秒;如果这样没能脱困,就倒车 1.0 秒并向另一侧转,绝不重复已经失败的动作。它沿用了 VDSG 运行时 [16] 的脱困规则(转向开阔处;绝不重复已失败的动作),但没有 VDSG 那种经过标定的脱困距离。在两场六分钟的模型比赛中,规则坦克被卡在墙边的时间占其存活时间的比例,v1 为 14.7%,v2 为 0.1%。得到同样事实的模型坦克在 v1 那场比赛中也被卡住:Claude 9.7%,llama3.2:3b 3.7%,DeepSeek 0.3%。
6 · 我们为什么输:来自回放的证据
6.1 · 对等的比较
§5 的汇总记录混合了不同的驾驶员版本和阵容。对等的比较是对等对抗:全部使用同一驾驶员版本的规则坦克,对阵数量相同的 BZFlag AI 坦克,比赛中别无他人,没有见证门控,也没有人工指令。有八场计入的比赛符合驾驶员 v2 的这一定义,每方 215.4 坦克·分钟:
| v2 对等对抗(8 场) | 击杀–阵亡 | K/D | 每分钟击杀 | 每分钟阵亡 |
|---|---|---|---|---|
| BZFlag AI | 645–389 | 1.66 | 2.99 | 1.81 |
| 我们的规则 v2 | 301–554 | 0.54 | 1.40 | 2.57 |
八场中每一场都是 BZFlag 的 AI 的 K/D 更高。差距出现在得分的两半:我们的驾驶员击杀的频率约为对方的一半,阵亡的频率约为对方的 1.4 倍。本节其余部分讨论的是后一半,因为驾驶员自己的学习循环最先看的就是那里,而且看错了。
6.2 · 第一个解释:每次死亡一个数据包
在有回放之前,每次死亡只保存最后一个状态数据包和驾驶员最后几次决策。一个基于规则的分类器根据这个快照给每次死亡指定一个原因:最后一次决策是闪避,就是闪避太晚;是 ENGAGE 在对准,就是瞄准时中弹,以此类推。在学习循环最初七场比赛中,驾驶员 v2 的 139 次死亡里,它把 88 次(63%)判为“闪避太晚”。学习循环据此尝试了更长的闪避窗口(在 1.8 秒而不是 1.2 秒时作出反应)。A/B 测试否决了它(§6.7)。
6.3 · 回放最后两秒
从 9 月 27 日 00:15 起,每一条死亡记录都附带最后两秒的状态数据包,每 40 毫秒一个。回放会重建致命炮弹:最后一个数据包中最接近命中的那发炮弹(预测会从坦克行进方向 8 米以内经过),并沿其直线弹道逐包向前追溯,因此一发炮弹绝不会因为它被发射之前的时刻而被算作“提前警告”。随后,在这条弹道的每一个数据包上重新运行每一条候选闪避规则:驾驶员自己的规则(相对于坦克所在位置的最近距离,4 米走廊,1.2 秒窗口)、走廊为 6 米和 8 米的同一规则、运动参照系规则(相对于坦克将要到达位置的最近距离),以及 BZFlag 自己的锥形规则。如果一条规则在命中前至少 0.5 秒首次标记了这发炮弹,它就算及时警告。每次死亡取第一个匹配的原因:
| 原因 | 条件 |
|---|---|
| 近距离中弹 | 致命炮弹在视野中不到 0.5 秒;任何闪避都来不及反应 |
| 闪避失败 | 驾驶员自己的规则及时标记了它并一直标记;坦克没能躲开 |
| 放弃闪避 | 驾驶员自己的规则及时标记了它,随后至少松手一次 |
| 提前量射击 | 自己的规则标记得太晚;运动参照系规则本可及时标记 |
| 擦身而过 | 自己的规则标记得太晚;更宽的走廊本可及时标记 |
| 未被标记的炮弹 | 在视野中足够久,但没有任何规则及时标记它 |
6.4 · 回放显示了什么
观察比赛 20260927-001524 让三辆 v2 坦克对阵三辆 BZFlag AI 坦克四分钟:我们 14–30,BZFlag 的 AI 32–16。我们的 30 次死亡中有 27 次有回放;引擎的 16 次中有 15 次有回放(图 6)。
- 我们的 v2:16 次放弃闪避,9 次提前量射击,1 次近距离中弹,1 次闪避失败。致命炮弹在视野中停留的时间中位数为 1.42 秒。
- BZFlag 的 AI:13 次近距离中弹,1 次提前量射击,1 次放弃闪避(按我们 v2 的规则判定,因为引擎 AI 有自己的规则)。它的致命炮弹在视野中停留的时间中位数为 0.40 秒。
我们的驾驶员大多死于看得见、也开始闪避的炮弹;引擎 AI 大多死于任何闪避都来不及的炮弹。这一模式在截止点之前每一次有回放的死亡上都成立:67 次有回放的 v2 死亡中有 34 次(51%)是放弃闪避,157 次有回放的 BZFlag AI 死亡中有 124 次(79%)是近距离中弹,致命炮弹在视野中的时间中位数为 0.33 秒。
6.5 · 机制:在自己边缘上来回抖动的闪避
放弃闪避,是一条切换规则在它的阈值处发生抖振。驾驶员的闪避方式是横穿炮弹的弹道。一旦炮弹对坦克的预测最近距离超过 4 米,规则的条件就不再成立,控制权落到下一条规则 ENGAGE 手里,它让坦克转向并驶向自己的目标。这一运动把坦克带回弹道附近,最近距离又落到 4 米以内,DODGE 再次触发。图 7 逐包显示了一次死亡,表 9 列出了死亡前驾驶员的最后几次决策。驾驶员完整的决策日志在每一次决策的粒度上显示了同一次死亡:从命中前 3.0 秒起,ENGAGE 一直瞄准 5 号敌人;命中前 1.17 秒 DODGE 接手,持续 0.33 秒;此后在最后 0.84 秒内,两条规则又交替了十次。
| 毫秒 | 规则 | 驾驶员自己的理由 |
|---|---|---|
| 0 | ENGAGE | enemy 5 168 m, lead −14.4° – aiming |
| 39 | DODGE | shot passes 4.0 m away in 0.27 s – cross its path |
| 82 | ENGAGE | enemy 5 166 m, lead −14.5° – aiming |
| 143 | DODGE | shot passes 4.0 m away in 0.16 s – cross its path |
| 197 | ENGAGE | enemy 5 164 m, lead −16.0° – aiming |
| 238 | DODGE | shot passes 4.0 m away in 0.08 s – cross its path |
| 280 | ENGAGE | enemy 5 162 m, lead −16.5° – aiming |
| 322 | DODGE | shot passes 3.8 m away in 0.01 s – cross its path |
实验线对这些死亡的最初说法是:目标通常就是开炮的那辆坦克,因此驾驶员转回了射手的火线。记录并不支持把这当作一般规律。根据每次死亡时保存的方位和距离确定驾驶员最后瞄准的目标的位置,在 16 次放弃闪避的死亡中,只有 3 次目标位于致命炮弹来向的 15° 以内,而有 12 次与之相差 90° 以上,远离炮弹飞来的方向。(敌方位置取的是死亡那一刻的位置,距炮弹首次出现最多 1.8 秒,因此这一检验是粗略的。)更常见的情况是:驾驶员正瞄着另一辆坦克,而来自别处的一发炮弹逼近。在每一次这样的死亡中反复出现的,是在走廊边缘的松手。
在 16 次放弃闪避的死亡中,驾驶员自己的规则首次标记致命炮弹的时间中位数为命中前 1.17 秒(范围 0.50–1.23 秒),松手次数的中位数为 9 次(范围 3–13)。警告来得足够早;驾驶员没有守住它。(在全部 27 次有回放的死亡上,这两个中位数分别为 1.02 秒和 6 次;实验线自己的记录引用的是这两个数字。)一辆每秒最多只能转 45° 的坦克,承受不起一个每隔几个数据包就把自己撤销的机动动作。
切换阈值处的抖振是一个老问题,也有一个老办法:迟滞,比如施密特触发器 [12],以及监督控制中的迟滞切换 [7]。在一个阈值处接通,只在更宽的阈值处才断开。驾驶员的基因 dodge_commit 正是如此:闪避一旦开始,就保持同一侧,直到那发炮弹已经过去,或它的最近距离达到走廊宽度的两倍。更宽的走廊则只是把边缘向外推,并不增加迟滞。
6.6 · 为什么单个数据包的解释是错的
最后一个数据包捕捉到的,是命中那一刻恰好处于的抖动阶段。在 16 次放弃闪避的死亡中,单包分类器把 9 次判为“闪避太晚”(最后一次决策是闪避),5 次判为“瞄准时中弹”(最后一次是 ENGAGE),2 次判为“提前量射击”。它开出的处方——更早闪避——针对的是一个其实已经提前一秒多标记了炮弹的驾驶员,而 A/B 测试否决了它。
第一个回放版本也不完全对。它测量的是每条规则在命中之前不间断地标记炮弹有多久。一条来回抖动的规则在最后几乎没有不间断的一段,所以那个版本把同样的 27 次死亡判读为“擦身而过”(15)、提前量射击(8)、未被标记(2)、近距离中弹(1)和闪避失败(1),并把 6 米走廊定为解决办法。分别统计首次标记和松手次数,而不是只看最后不间断的一段,才让抖动暴露出来。6 米走廊还是被测试了;§6.7 报告了结果。
6.7 · 学习循环,以及它为何没有更早学会
驾驶员的学习循环遵循 [15] 中失败优先的形态:观察死亡、解释死亡、改动一个有名字的行为(一个基因)、验证、保留或否决。基因涵盖闪避的参照系(坦克所在位置、将要到达的位置,或 BZFlag 的锥形)、走廊和窗口,驾驶员如何逼近(半速直线或 BZFlag 的蛇形)、后退距离、两发炮弹之间的间隔、开火后的规避机动、瞄准中的前馈项,以及 dodge_commit。每个基因初始都是关闭的。验证是在同一批比赛内进行的 A/B 测试:两辆坦克用当前驾驶员,两辆用候选,两辆是 BZFlag AI,同一张随机地图,同一时刻。每一组按每坦克·分钟的净得分(击杀 − 阵亡)计分;差值除以泊松标准误,每组为每坦克·分钟 \(\sqrt{k+d}\)。循环在 \(z \ge 2\) 时晋升,在 \(z \le -1\) 时否决,否则记为“尚未证实”。
| 时间 | 基线 | 尝试的改动(针对的死因) | 比赛场数 | z | 决定 |
|---|---|---|---|---|---|
| 23:39 | v2 | 闪避窗口 1.8 秒(闪避太晚,57%,单个数据包) | 2 | −1.65 | 否决 |
| 23:52 | v2 | 逼近时蛇形(瞄准时中弹,24%) | 3 | +0.69 | 尚未证实 |
| 00:04 | v2 | 运动参照系闪避(提前量射击,9%) | 3 | +0.77 | 尚未证实 |
| 00:27 | v2 | 6 米走廊(擦身而过,56%,第一个回放版本) | 2 | +3.08 | 晋升:v3 |
| 00:40 | v3 | 50 米以内后退(近距离中弹,91%) | 3 | +0.43 | 尚未证实 |
| 00:44 | v3 | 同一改动,合并证据 | 4 | +1.03 | 尚未证实 |
| 01:01 | v3 | 同一改动,合并证据 | 7 | +1.80 | 尚未证实 |
| 01:05 | v3 | 同一改动,合并证据 | 8 | +1.74 | 尚未证实 |
有三件事让循环没能更早找到原因(表 10)。
- 解释是错的。单包取证把循环引向“闪避太晚”,而它提出的改动被否决了——这是正确的。一个循环只能检验它的证据所提出的假设。
- 证据被丢掉了。一个在三场比赛后“尚未证实”的改动会被永久搁置,连同它的比赛一起。运动参照系闪避在它的全部三场比赛中都领先,蛇形在三场中领先两场。循环现在会跨代合并一个改动的比赛,最多九场,直到作出决定。
- 解决办法不在基因空间里。没有任何基因表达“对同一发炮弹坚持闪避”。dodge_commit 是在回放显示出抖动之后才加入的。到截止点为止,它还没有在任何比赛中测试过,因为那时晋升后的驾驶员已经不再这样死去(见下文)。
截止点时循环所处的位置。6 米走廊在 00:27 晋升为 v3,此前的两场 A/B 比赛中,它的坦克打出 32–24,而当前驾驶员为 17–42(\(z = +3.08\))。走廊更宽后,松手发生在离弹道更远的地方,v3 的死亡性质也随之改变:截止点之前 11 场比赛中 124 次有回放的 v3 死亡里,106 次(85%)是近距离中弹,14 次闪避失败,2 次提前量射击,1 次未被标记,放弃闪避只有 1 次。这是 BZFlag AI 死亡的特征,而不是 v2 的。在 v3 唯一一场对等对抗中(20260927-004504,每方 11.7 坦克·分钟),BZFlag 的 AI 仍然获胜,28–22 对 v3 的 15–20。v3 的阵亡频率低于引擎 AI(每坦克·分钟 1.71 对 1.88),击杀频率却只有对方的一半左右(1.28 对 2.39)。就这一场比赛而言,差距已从防守转移到进攻。循环尝试的下一个改动——BZFlag 自己的 50 米以内后退——在它的八场比赛中有七场领先,截止点时仍尚未证实(\(z = +1.74\))。我们报告这次晋升时附带两点提醒。两场四分钟的比赛是很少的证据。而且一个每场比赛后都做检验、在 \(z \ge 2\) 时晋升的循环,是在对不断累积的数据反复查看,因此它真实的误晋升率高于单次 \(z\) 检验 [2]。
7 · 开火的见证门控
在 BZFlag 中,每个驾驶员都根据引擎状态做决定,而引擎知道坦克看不到的东西:建筑后面的敌人仍然在数据包里。只凭数据包开火的驾驶员可能会盲射。因此这条实验线运行着第二个见证者:一个学习得到的检查,它查看坦克自己渲染出的视角,并对引擎声称存在的每一个敌人说明它是否可见(看见)、不可见,还是无法判断。眼睛本身、它如何由引擎教会,以及它被允许启用之前必须通过的关口,是另一篇论文的主题 [18];把眼睛作为引擎这一“第一见证者”之外的第二见证者,这一想法来自 VDSG [16]。这里我们只描述它的作用,并测量它对开火的影响。
作用。见证开火开启时,我们的规则只能向眼睛当前确认的敌人开火;模型坦克的开火会被扣住,除非眼睛确认了离其炮线最近的那个敌人。BZFlag 的 AI 从不查询眼睛。眼睛只判断 350 米以内的声明,并在 12 米以内的抵近距离弃权,因为那时坦克会溢出视野。我们坦克的每一发炮弹都在发射瞬间对照引擎的深度缓冲评分:目标可见部分不超过 5% 的一发即为盲射。
重点比赛。比赛 20260926-225220 让三辆开启见证开火的 v2 规则坦克对阵三辆 BZFlag AI 坦克三分钟,每一发炮弹和每一次扣住的开火都记录在黑匣子里。75 发炮弹中 0 发是盲射,而且全部 75 发的目标都经过眼睛确认。驾驶员扣住开火 26 次。其中十二次属于同一次遭遇:我们的一辆坦克和一个敌人相距 0.2–1.3 米,持续 1.75 秒,眼睛在抵近距离弃权,驾驶员一次又一次地扣住开火。其余十四次中,记录的判定有八次是“未看见”,三次是“无法判断”,一次是“看见”(我们没有调查这一不一致),另有两次没有记录判定。
跨比赛来看。在每一场结果中记录了评分炮弹的计入比赛里,无论有没有门控,盲射都很少见:开启见证开火时 197 发中 1 发(三场比赛),关闭时 3,012 发中 10 发(24 场比赛)。驾驶员自己的检验——只在引擎中视线无遮挡时开火——已经避免了大多数盲射。因此在这些比赛中,门控可测量的效果就是那些扣住的开火,而在抵近距离,这些被扣住的正是驾驶员需要的射击。门控真正的用途,是约束一个我们没有编写其瞄准方式的驾驶员:模型坦克。没有任何计入的比赛在开启见证开火的情况下运行过模型坦克,因此对模型扳机的门控已经实现并有单元测试把关,但尚未在比赛中测量。在 12 米以内眼睛无法框住目标的地方信任引擎的视线,是降低抵近代价的一个显而易见的办法;它尚未实现。
8 · 讨论
8.1 · 决策频率买到了什么
在 BZFlag 中,一发炮弹一秒钟飞过 100 米。我们 v2 驾驶员所死于的致命炮弹,在视野中停留的时间中位数是 1.4 秒,击杀 BZFlag AI 的则是 0.4 秒。一个每 7.5 秒才决策一次的驾驶员无法及时应对一发炮弹;它唯一的防御是几秒钟前下达的一条指令。一个每秒决策一次的驾驶员,在我们自己的驾驶员所获得的那段预警时间里,最多也只有一次决策机会。执行模型指令的伺服器按设计从不闪避:比较的是驾驶员,而一个会闪避的伺服器就等于我们的规则在替模型开坦克。在这一约定下,模型坦克可以瞄准,却无法避免被击中,它们的每分钟阵亡数说明了这一点。
模型并没有通过谨慎驾驶来弥补。在主赛中,按存活时每秒一次的采样,它们的平均指令速度为:Claude 为满速的 0.64,DeepSeek 为 0.80,规则为 0.71(llama3.2:3b 为 0.42)。这与我们的驾驶模拟器研究不同:在那里,每一个坐在方向盘前的语言模型都以 8–10 公里/小时爬行,因为在 0.8–2.0 秒的两次“瞥视”之间它是在盲开 [17, §5.4]。机制相同——两次瞥视之间保持旧指令;反应不同,是因为汽车最坏的情况取决于自己的速度,而坦克最坏的情况取决于别人的炮弹。
规则的决策次数约为最快模型的 145 倍。我们并不主张速度就是全部:在不计时间的考试中,规则同样胜过每一个模型。在模型之间,最快的(DeepSeek)在竞技场中表现最好,而考试最好的(Claude)排在它后面;llama3.2:3b 比 Claude 快,但给出的答案几乎不变,表现最差。
8.2 · 考试显示了什么,竞技场显示了什么
考试问的是驾驶员在一个冻结的局面中是否知道该做什么;竞技场问的是它能否及时地、持续地做到。Claude 在考试中是最好的模型(8 题中答对 6 题),在竞技场中却是倒数第二(1–15);DeepSeek 考试答对 5 题,却是竞技场中最好的模型。两种测量单独都不能为驾驶员排出名次。
考试还有一个更尖锐的局限,而这恰恰对我们自己的驾驶员至关重要:单帧考试无法包含存在于序列之中的缺陷。表 9 中的每一次决策就其本身而言都是正确的:预测会从 4 米以内经过的炮弹就闪避,没有就瞄准。失败在于二者之间的切换,只有跨越多个数据包才能看见。规则在考试中得了 8 分(满分 8),而造成 v2 驾驶员大多数有回放死亡的那种抖动,对考试来说是不可见的。
8.3 · 为什么引擎 AI 获胜是最重要的结果
本文中其他每一个对手都是我们选的或我们造的:随机操作和去掉扳机的驾驶员,用来说明规则并不平凡;还有接在我们设计的接口后面的语言模型。BZFlag 的 AI 是唯一一个不是我们编写的对手,也是唯一一个能告诉我们,我们的规则离好的规则还有多远的对手。它是上游游戏的一部分,由游戏自己的贡献者编写,并且原封不动地运行。没有它,记录会写着“规则击败了每一个模型”,然后就此打住。有了它,记录写的是:击败这些语言模型驾驶员,不需要在决策环节中放一个神经网络;要击败引擎,需要比我们更好的规则。后半句才是发现。
引擎 AI 还以身作则地给了我们一课。它的死亡几乎都来自任何人都躲不开的炮弹,这正是一个善于闪避的驾驶员的死亡应有的样子。6 米走廊晋升之后,我们驾驶员的死亡也变成了同样的形态(85% 为近距离中弹)。在此后唯一一场对等比赛中,它的阵亡频率低于引擎 AI,却仍然输了,因为它的击杀频率只有对方的一半。那只是一场四分钟的比赛,我们把它看作一个值得探究的方向,而不是一个结果。
8.4 · 这场失败对“从失败中学习”说明了什么
驾驶员的学习循环有一个可靠的验证步骤,却有一个薄弱的解释步骤。A/B 测试否决了单包取证提出的错误改动,这正是验证的意义所在。但它无法提出正确的改动,因为一个循环只能检验它的证据所生成的假设。回放两次改变了证据。第一个版本把抖动读成了走廊太窄,因为它只测量最后那段不间断的警告。第二个版本分别统计首次警告和松手次数,才说出了机制。失败优先论文提醒过,功劳分配会悄无声息地出错 [15];这里它出错得足够“响亮”,之所以能被发现,只是因为回放保存的是两秒,而不是一个数据包。同样的形态也以较小的规模出现在 BattleZone 中:闪避实验台的证据是存活,而游戏的目标是摧毁,只有在游戏自己的分数上所做的验证才发现了这一点。
10 · 局限与效度威胁
样本很小。主赛的竞技场结果是一场十分钟的比赛。计入的模型比赛有六场,其中两场不到三分钟。驾驶员 v3 只打过一场对等对抗。循环的 A/B 比赛每场四分钟。考试中每个局面只问一次。BattleZone 每组十个种子,足以把驾驶员与随机操作区分开,却不足以把 DODGE 组与驾驶员区分开。我们在每个结果旁边写明 \(n\),除表格明确说明之处外,不跨条件合并。
每个模型只有一种配置。每个语言模型都只用一个系统提示词、一个输出结构、一个伺服器,提示词中没有示例;我们没有为每个模型分别调校提示词。Claude 通过 claude -p 接口运行,effort 为 “low”,从未经由其 API;DeepSeek 从一个地点经由其公共 API;Llama 是在测试机器上运行的 3B 模型。换一个提示词、接口、effort 设置或模型规模,这些结果中的任何一个都可能改变。伺服器按设计从不替模型闪避。由模型选择目标、由规则负责闪避的混合方案没有测试过。
存在不对等之处。BZFlag 的 AI 在客户端内部运行,没有传输延迟;我们的控制器通过本地套接字应答,指令会在稍后的一帧才生效。状态数据包只报告 200 米以内、一个坦克高度范围内的炮弹;引擎 AI 直接读取自己的世界,不过它的闪避只考虑 100 米以内的炮弹。在各类别数量不等的自由混战中,一个类别的 K/D 包含了其自身坦克之间的交火。A/B 阵容中有我们的四辆坦克和引擎的两辆。我们只依据模型阵容(每个驾驶员一辆坦克)或对等对抗阵容(两类驾驶员数量相等)来说一个驾驶员胜过另一个;A/B 阵容只用来比较一个驾驶员与其候选。
地图。每场比赛都在服务器生成的一个新随机世界上进行,这增加了比赛之间的方差,也排除了针对某一张地图调校的可能。同一场比赛内的比较共享地图;跨比赛的比较则不然。
取证。一次死亡的原因只有一个标签,取第一个匹配的原因。这些标签依赖于阈值:命中前 0.5 秒的警告算作及时;致命炮弹必须从 8 米以内经过;数据包每 40 毫秒保存一个;假定炮弹沿直线飞行。没有人对照录像核查过这些标签。单包分类器错得被回放揭露了出来,而回放分类器也可能以我们尚未发现的方式出错。
循环的统计。A/B 统计量把击杀和阵亡视为泊松计数,并在每场比赛后检验。反复查看会抬高误晋升的概率 [2],而 v3 是在两场四分钟的比赛后晋升的。截止点之后循环仍在运行,因此 v3 可能被取代,也可能退步;本文报告的是截至 2026 年 9 月 27 日 01:05:50 的记录,此后的内容一概不含。
BattleZone 的具体情况。一个 ROM、十个种子、v5 默认的粘滞动作。对 25 条死亡画面条带的人工判读是粗略的。DQN 和人类的数字引自不同的协议,只是背景,不是比较。
崩溃与排除。BZFlag 的 OpenGL 客户端在 macOS 下可能崩溃;一次这样的丢失让第一场十分钟比赛作废。加入监管之后,到截止点为止没有任何一场有记录的比赛发生客户端退出。有七次运行被排除,每一次都列明了原因(表 7)。所有测量均由构建这些系统的团队完成。
11 · 结论
一个决策环节中没有神经网络的规则驾驶员,只看像素就能把 Atari BattleZone 玩得远高于随机操作。在一个实时 3D 竞技场中,它击败了三个拿到同样事实的语言模型驾驶员——六场计入的模型比赛中赢了五场,汇总也胜出——这得益于它每秒决策一百次,而它们每一到十六秒才决策一次。在每一场对等比赛中,它都输给了游戏自带的 AI。这场失败才是有用的结果。它的第一个解释是错的,第二个只对了一半,第三个——对每次死亡前最后两秒的回放——显示出一个驾驶员提前一秒多就看到了致命炮弹,开始闪避,却一次又一次地在自己走廊的边缘放开了闪避。更宽的走廊已经改变了驾驶员的死法。它还没有让驾驶员赢,而回放所指向的迟滞修正还没有被测试。等它被测试之后我们会报告结果,包括它输了的情况。
参考文献
- M. Alshiekh, R. Bloem, R. Ehlers, B. Könighofer, S. Niekum, U. Topcu. Safe reinforcement learning via shielding. In Proc. AAAI Conference on Artificial Intelligence, 2018.
- P. Armitage, C. K. McPherson, B. C. Rowe. Repeated significance tests on accumulating data. Journal of the Royal Statistical Society, Series A 132(2):235–244, 1969.
- A. P. Badia, B. Piot, S. Kapturowski, P. Sprechmann, A. Vitvitskyi, D. Guo, C. Blundell. Agent57: outperforming the Atari human benchmark. arXiv:2003.13350, 2020.
- M. G. Bellemare, Y. Naddaf, J. Veness, M. Bowling. The Arcade Learning Environment: an evaluation platform for general agents. Journal of Artificial Intelligence Research 47:253–279, 2013.
- R. A. Brooks. A robust layered control system for a mobile robot. IEEE Journal of Robotics and Automation 2(1):14–23, 1986.
- BZFlag. Open-source multiplayer 3D tank battle game. github.com/BZFlag-Dev/bzflag;从提交 4299415(2026 年 9 月 8 日)构建。
- D. Liberzon. Switching in Systems and Control. Birkhäuser, Boston, 2003.
- W. Ma, Q. Mi, Y. Zeng, X. Yan, Y. Wu, R. Lin, H. Zhang, J. Wang. Large language models play StarCraft II: benchmarks and a chain of summarization approach. arXiv:2312.11865, 2023.
- M. C. Machado, M. G. Bellemare, E. Talvitie, J. Veness, M. Hausknecht, M. Bowling. Revisiting the Arcade Learning Environment: evaluation protocols and open problems for general agents. Journal of Artificial Intelligence Research 61, 2018. doi:10.1613/jair.5699.
- V. Mnih, K. Kavukcuoglu, D. Silver, A. A. Rusu, J. Veness, M. G. Bellemare, A. Graves, M. Riedmiller, A. K. Fidjeland, G. Ostrovski, S. Petersen, C. Beattie, A. Sadik, I. Antonoglou, H. King, D. Kumaran, D. Wierstra, S. Legg, D. Hassabis. Human-level control through deep reinforcement learning. Nature 518(7540):529–533, 2015.
- D. Paglieri, B. Cupiał, S. Coward, U. Piterbarg, M. Wolczyk, A. Khan, E. Pignatelli, Ł. Kuciński, L. Pinto, R. Fergus, J. N. Foerster, J. Parker-Holder, T. Rocktäschel. BALROG: benchmarking agentic LLM and VLM reasoning on games. In International Conference on Learning Representations (ICLR), 2025. arXiv:2411.13543.
- O. H. Schmitt. A thermionic trigger. Journal of Scientific Instruments 15(1):24, 1938.
- L. Sha. Using simplicity to control complexity. IEEE Software 18(4):20–28, 2001.
- N. R. Waytowich, D. White, MD Sunbeam, V. G. Goecks. Atari-GPT: benchmarking multimodal large language models as low-level policies in Atari games. arXiv:2408.15950, 2024.
- Perslis Research. 失败优先模型:失败成为结构。研究论文,2026。research.perslis.com/fail-first.zh
- Perslis Research. VDSG:面向自主智能体的受指挥准入控制运行时。系统论文,2026。research.perslis.com/vdsg.zh
- Perslis Research. 光真实驾驶仿真器上的运行时准入控制。实证研究,2026。research.perslis.com/carla-admission.zh
- Perslis Research. 见证之眼。论文撰写中,2026。research.perslis.com/witness-eye
附录 A · 每个数字的来源
本文中的每一个数字,连同其来源,都列在随附的声明文件中。来源是两条实验线自己的证据文件,读取时未作任何修改;为撰写本文,没有在任何一款游戏中重新运行任何东西。三个分析脚本从这些文件中重新计算出每一个派生数字。它们以数据冻结时的实验线提交版本(6f76e6a)导入 BZFlag 实验线自己的分析代码(比赛计数、取证、驾驶员基因),用 git show 提取到一个临时目录中,因此之后对这条仍在运行的实验线所作的修改不会改变这里的数字。
| 结果 | 来源 |
|---|---|
| BattleZone 各组、逐种子得分、DODGE 验证 | 坦克实验线的 evidence/eval_v1.jsonl 和 eval_v2.jsonl(每组十个种子);统计由 analysis/battlezone_stats.py 计算 |
| 闪避实验台 | 坦克实验线的 evidence/dodge_lab.json |
| 死亡窗口与图 2 | 坦克实验线的 evidence/deaths/(25 个窗口;图中裁剪自 1_3.png) |
| DQN、人类和随机的参考得分 | [10],扩展数据表 2 与方法部分 |
| 竞技场比赛、主赛表、决策时间、汇总记录、排除、卡住比例 | 外置硬盘上每场比赛的 meta.json、results.json、scoreboard.jsonl 和黑匣子,截至运行 20260927-010140;analysis/arena_analysis.py |
| 驾驶考试 | BZFlag 实验线的 evidence/exam.jsonl(48 个答案);analysis/exam_stats.py |
| 死因、回放、示例轨迹 | 每场比赛的 deaths-*.jsonl(自 9 月 27 日 00:15 起每次死亡附两秒数据包),由实验线在 6f76e6a 处的取证代码分类,并以其早期版本 96259ea 与 07a04e2 作对照 |
| 学习循环的决定 | BZFlag 实验线的 evidence/pilots/evolution.jsonl 和 evolve.log,截至 01:05:50 的记录 |
| 见证开火 | shots-*.jsonl(逐发记录,自运行 20260926-225220 起)和 results.json 中的计数 |
| 引擎事实(炮弹速度、坦克尺寸、转向速率、AI 的规则、随机世界) | BZFlag 在 4299415 处的源码:src/common/global.cxx、src/bzflag/AutoPilot.cxx、src/bzfs/bzfs.cxx、WorldGenerators.cxx |
复现这些数字。在论文目录下,依次对 analysis/battlezone_stats.py、arena_analysis.py 和 exam_stats.py 运行 python3 -B(它们写出 analysis/out/*.json),然后运行 figure_data.py(生成 PDF 和本页使用的图表坐标)。这些脚本只读不写;-B 让 Python 不会把字节码写进实验线目录。
图。图 2 是坦克实验线所记录的死亡画面条带中的六帧,经裁剪,未重新渲染。其余每一幅图都由其旁边表格中的数字绘制。在本网页版中,图 1 和图 3–7 由与 PDF 相同的数字重新绘制。
如何引用
Perslis Research. Rules at the Wheel: Tanks, Language Models and an Honest Loss(方向盘上的规则:坦克、语言模型与一场诚实的失败). 研究原型,2026 年 9 月。https://research.perslis.com/tank-arena
@techreport{perslis2026tankarena,
  title       = {Rules at the Wheel: Tanks, Language Models and an Honest Loss},
  author      = {{Perslis Research}},
  institution = {Perslis Research},
  year        = {2026},
  month       = {9},
  note        = {Research prototype; simulation and games; not a certified safety system.},
  url         = {https://research.perslis.com/tank-arena}
}