AI 系统 · 一项感知核对的实证研究 · 研究原型(仿真与游戏)
是见证者,不是检测器
用像素核对游戏引擎的声明,以及这一核对对读取它的决策究竟值多少。一只眼睛,对引擎的每一条声明只回答一个问题(看见、未看见,还是无法判断),在《德军总部 3D》与 BZFlag 中测量,其中包括一个恰恰出现在最关键之处的零结果。
游戏引擎知道每个物体在哪里;它却无法告诉智能体,摄像机是否真的拍到了它。我们研究一只只回答这个问题的眼睛:对引擎的每一条声明(类别、距离、方位),它给出看见、未看见或无法判断。在《德军总部 3D》的一个规则驾驶员中,原有的眼睛其实没有接到任何对敌人做决定的环节上:“在视野内”来自瓦片地图上中心到中心的射线,而眼睛的老师只教那些地图已经看见的敌人,于是眼睛一个敌人样本也没有。一个只能确认的见证步骤、一个由几何驱动的老师和一个开关修好了这条连线;在每组三个 120 秒的时段中,眼睛每分钟多给出约两次目击,而死亡、击杀和受伤次数保持持平。在 BZFlag 中,自由搜索式的坦克检测精确率只有 3.5%。改为逐条判断引擎的声明——预测方框、近者优先的遮挡、屏蔽光晕、读起来像规则的深度为 2 的提升树——之后,在同一场比赛的 7,863 帧上做分块 4 折交叉验证,它通过了一个固定的关口:召回率 0.984,1,258 条隐藏声明中误确认 6 条(0.48%;95% 区间 0.18–1.04%),其中五条落在同一折。此后在 28 场新随机地图的比赛中,现场召回率为 0.982。但规则驾驶员自己的视线检验本来就避免了盲射,所以这一核对没有阻止任何我们能测到的盲射,而它扣住的开火让我们在看得见的目标上少打了炮弹。核对一条声明,比在画面中搜索更容易做得可靠;而这一核对值多少,由读取它的决策决定。
核对一条声明的见证者,比到处搜索的检测器更容易做得可靠。这一核对值多少,由读取它的决策决定,也必须在那里测量。
问题。在电子游戏里,游戏本身准确知道每辆坦克、每个守卫在哪里,连躲在建筑后面的也知道。一个只按游戏名单开火的电脑玩家,会向它根本看不见的坦克开炮。玩家需要的,是一只回答比“屏幕上有什么?”更简单的问题的眼睛:游戏说那边有一辆坦克;摄像机真的看得见它吗?
我们做了什么。第一次尝试是在整个画面里到处找坦克,结果总把深色石墙当成坦克:它找到的东西里只有 3.5% 真是坦克。于是我们换了问题。新的眼睛拿到游戏声明的每一个物体,算出它在屏幕上必须出现的位置和大小,只检查那一处。它回答“看见”“未看见”,或“判断不了,原因如下”。它在游戏运行时由游戏来教,在通过一场事先定好的严格考试之前,不允许它操纵任何坦克。
结果如何。它通过了考试,但只是勉强:它找到了 98.4% 的可见坦克,替隐藏坦克作错误担保的情况大约每 200 次有 1 次。在之后 28 局它从未见过的地图上,它仍找到了 98.2%。然后我们检查它为坦克做了什么,诚实的回答是:没有任何我们测得出的作用。我们的坦克本来就拒绝向游戏说在墙后的东西开火,所以眼睛已经没有盲射可以阻止;有时它还会对一辆明明看得见的坦克扣住开火。在第二款游戏《德军总部 3D》中,修好一只原本什么都没接上的眼睛,同样没有改变玩家的成绩。
它不是什么。不是产品,不是完成的视觉系统,也不是“这只眼睛能让玩家更强”的主张。它是游戏中的研究原型,样本很小,每个数字旁都写明了规模。
1 · 引言
游戏引擎为世界中的每个物体保存着一份精确的名单:每辆坦克或每个守卫站在哪里、有多远、在什么方位。这份名单并不等于摄像机拍到的画面。200 米外的一辆坦克可能站在建筑后面;一个半个身子露在门口的守卫可能完全在视野中,而一个粗糙的视线检验却说它被挡住了。只凭引擎的数字开火的驾驶员会盲射;信任粗糙视线检验的驾驶员,会无视正在向它开火的守卫。
本文要讲的,正是为这道缝隙而造的一只眼睛。它不在画面中搜索物体。它拿到引擎的每一条声明(类别、距离、方位),只回答一个问题:这一帧拍到它了吗?答案是三种判定之一:看见、未看见或无法判断,并附上理由。我们把这样的眼睛称为见证者:它就别人做出的声明作证,也可以拒绝作证。图 1把它与检测器作对比。
我们报告两个相互关联的结果,第二个由第一个引出。
A. 一只没有接到任何决策上的眼睛(§3)。我们的受指挥游戏运行时 VDSG [2] 原本就有一只眼睛:它在游戏进行中由引擎来教,在画面上标出门和墙。在它的《德军总部 3D》实验线中,我们发现没有任何对敌人做决定的环节读取它。驾驶员的“在视野内”来自瓦片地图上中心到中心的射线,而眼睛的老师只在这条射线已经判定敌人可见时才教它,于是眼睛一个敌人样本也没有,永远不可能成为敌人的第二见证者。我们用三样东西修好了连线:一个只能确认雷达上已列出的敌人或拾取物的见证步骤、一个由屏幕几何驱动的老师,以及一个带分组台账的眼睛开关。在一层关卡上测量,眼睛每分钟贡献约两次目击,却没有改变任何我们测得出的东西:持平。
B. 为引擎声明作证的见证者(§4–§6)。BZFlag 是一款 3D 坦克游戏,我们的规则驾驶员、三个语言模型驾驶员和游戏自带的 AI 共用一个全程录像的竞技场 [4]。我们先做了一个检测器。自由搜索的精确率只有 3.5%:深色石墙看起来就像坦克。我们用一个与游戏无关的见证者 vcard-eye 取代了它,由它逐条判断引擎的声明:预测被声明的坦克在屏幕上必须出现的位置,排除无法判断的情形(更近的物体、方框上的光晕、引擎自己的标记、抵近距离),再用深度为 2 的提升树作决定,每条树路径都读作一条“如果……那么……”规则。它在分块交叉验证下通过了事先固定的关口,余量很薄;它在之后 28 场比赛中的现场召回率保持在交叉验证结果的附近。随后我们测量它对驾驶员的价值,发现在这个竞技场里,驾驶员自己的视线检验早已避免了这只眼睛本来要阻止的盲射。
我们得出的教训,只陈述到这两个案例所能支撑的程度:
这一核对值多少,由读取它的决策决定,也必须在那里测量。
贡献
- 一次诊断、一次修复和一个零结果(§3)。我们展示了一只由引擎教出来的眼睛,为什么会对唯一要紧的那一类物体一无所学;用只能确认的见证规则和几何老师修复它;并在同一个引擎上用交替时段比较眼睛开与关:持平,连同其混杂因素一并报告。
- 一只与游戏无关的见证之眼(§4)。由距离和方位按 \(1/d\) 曲线预测方框、近者优先的遮挡、按从像素测得的光晕范围做屏蔽、引擎标记与三种弃权类型、读起来像规则的提升树核验器、从像素读出的瞄准方位、一种标准的老师样本格式、一个接入循环,以及一个用同样方式接入新游戏的模型上下文协议(MCP)服务器。
- 一套评估流程及其结果(§4.4、§5)。按连续分块的 4 折交叉验证;在折外分数上以关口误确认上限的一半设定判定阈值;一个任何驾驶员据以行动之前眼睛必须通过的关口;以及一条在同一批帧、同一组折上重新评估眼睛每个阶段的演化曲线。这条曲线并不单调,我们报告原因。
- 在决策处的测量(§6)。28 场新地图比赛中的现场召回率、核对开与关时的盲射,以及对照引擎深度缓冲逐一评分的每一次扣住开火。在这个竞技场里,这一核对没有阻止任何测得出的盲射,而它扣住的开火让我们少打了炮弹。
我们主张什么,不主张什么
我们主张下文的各项测量,每项旁边都写明了样本规模。我们不主张见证之眼在它所测的两款游戏(BZFlag,以及测试中的一款合成游戏)之外同样准确,不主张它在报告的 28 场现场比赛之外能跨地图推广,也不主张它能让任何驾驶员玩得更好:在两条实验线中它都没有做到。与自由搜索的比较不是受控比较:检测器在两种配置之后就被放弃,我们把它作为改换问题的理由来报告,而不是作为关于检测器的一般结论。各项思想都注明了来源(§9);验证优先的框架出自我们自己的早期工作 [1]、[2]。所有数字都是我们自己的,没有任何一项经过第三方复现。凡是只以会话日志中记录的工具输出形式留存、而没有已提交证据文件的数字,我们都会说明(§8)。
2 · 术语,以及本文所依托的工作
误确认就是见证者版本的盲射,§4.4 中的关口正是用这些术语写成的:只向已确认声明开火的驾驶员,只有在眼睛误确认时,或者在判定与开火之间的那一瞬目标离开视野时,才可能盲射。
我们的早期工作
四份早期报告奠定了框架,我们引用而不重复它们。TinkyVision [1] 把一个视觉层描述为“感知与见证,而非控制权威”:它让模型看见并记录所见,但不决定模型可以做什么。我们沿用这个词并把它收窄:这里的见证者,是为别人做出的声明作证。VDSG [2] 是一个受指挥的运行时,它依据关于事实的规则决定游戏驾驶员可以做什么,而指令只能收窄可容许集合。它引入了一只在游戏进行中由引擎教导的眼睛——一个逐列的颜色标注器,作为引擎这一第一见证者之外的第二见证者,“其分歧是操作员能读到的一个数字”;它测得这只眼睛与老师的一致率在 DOOM 上为 78–92%,在《德军总部 3D》上为 79%(四个类别参与投票)。方向盘上的规则 [4] 描述了本文所用的 BZFlag 竞技场:每辆坦克都是自己的游戏客户端,每个驾驶员读取同一份引擎状态,每场比赛一张新的随机世界地图,我们的规则驾驶员、BZFlag 自带的 AI,以及一个除非眼睛确认目标否则扣住开火的门控。那篇论文测量了门控对开火的影响;本文描述门控背后的眼睛,并延伸那项测量(§6)。失败优先论文 [3] 把一个与基线持平的 DOOM 记忆(配对 \(t=0.78\))如实报告为持平;我们沿用这一做法。
3 · A:一只什么都没决定的眼睛(VDSG,《德军总部 3D》)
3.1 驾驶员如何看见敌人
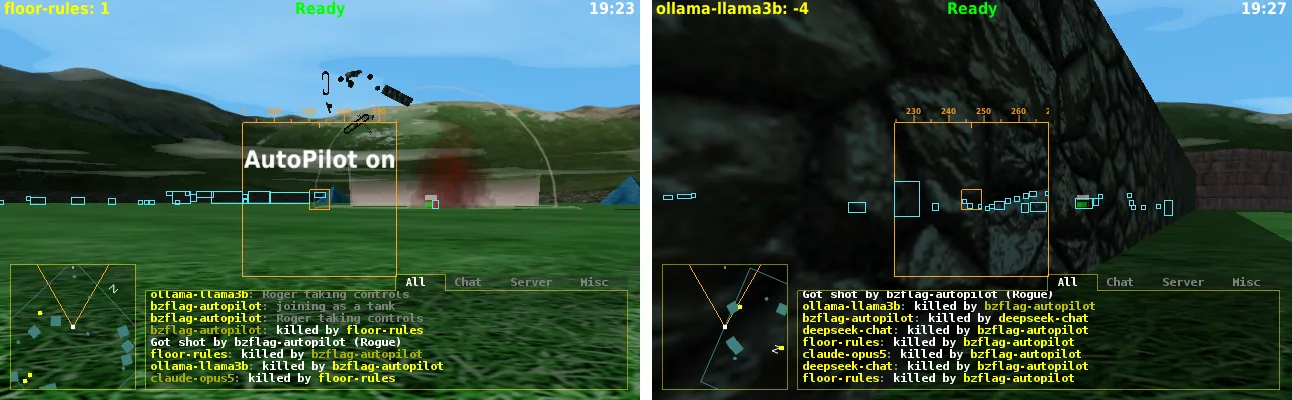
VDSG 的德军总部实验线在一个加了接口的 ECWolf 引擎下运行 1992 年的 WL6 数据 [2]。它的态势报告从引擎的物体列表(即“雷达”)列出每个敌人和拾取物,各带距离、方位和一个标记 in_view。这个标记就是瓦片地图自己的视线检验:物体必须位于 90° 视场之内,而且从驾驶员位置到物体位置采样的一条线段不能穿过任何阻挡的瓦片(wolf_floor/state.py 第 81–90 行与第 102 行,提交 71b94d1)。规则策略只与设置了 in_view 的敌人交战,而目标 ATTACK 只有在存在这样的敌人时才可容许 [2]。中心到中心的线段是一个粗糙的检验:一个半个身子从门框后面露出来的守卫,或者站在一扇敞开的门口、线段却擦到门框的守卫,在向驾驶员开火时被报告为“(未看见)”。
这只眼睛本应恰好为此充当第二见证者。它没有。它的输出只在三个地方到达驾驶员:一个证明前方瓦片是门的第二见证(按下 USE 的理由)、驾驶员卡住时为脱困动作定尺的距离剖面,以及画在控制台页面上的卡片。三者都与敌人无关。更糟的是,眼睛的老师依据地图为每一列屏幕贴标签,只有当地图已经判定某个敌人可见时,才教这个敌人所占的各列。于是眼睛只能学到地图已经看见的东西,永远不可能为地图没看见的东西作证。修复之前的一次控制台运行把这一点表现得清清楚楚:眼睛的颜色样本为天花板 4,686、地面 3,141、墙 27,068、门 7,757、敌人 0、拾取物 0。
3.2 修复
提交 71b94d1 做了四项改动,每一项都在它适用的每个位置由测试把关(该提交时 DOOM 实验线有 186 个测试,德军总部实验线有 12 个,覆盖两个循环、两个控制台和两套报告文本)。
由几何驱动的老师。现在,一个精灵在它身体覆盖的每一列屏幕上都会被教给眼睛,只要它站得比那一列射线碰到的墙更近,不论地图的视线检验是否通过。控制台重启后 38 秒内,眼睛已有 1,043 个敌人颜色样本;128 秒后为 8,912 个。
只能确认的见证步骤。每次决策时,地图判为未看见的每一个雷达敌人或拾取物,都要与眼睛当前的卡片比对(doom_floor/witness.py)。记 \(b_e\)、\(d_e\) 为该物体的雷达方位与距离,\(\phi=90^\circ\) 为视场,当下式成立时,该物体被标为由眼睛看见:
其中取方位最接近的卡片 \(k\)。这一步只能把雷达上已经列出、屏幕上可能出现的东西从“未看见”改为“看见”。它不能凭空造出物体,不能删除物体,也不能在屏幕之外起作用,所以一次误报最多让驾驶员提早瞄准一个已列出的敌人,绝不会让它瞄准一面空墙。它确实扩大了驾驶员可以交战的范围:被翻转的敌人会让 ATTACK 变得可容许。这是计算可容许集合所依据的事实发生了变化,而不是一条指令;VDSG 的指令仍然只能收窄。
开关与台账。眼睛关闭时,驾驶员不看也不学,卡片、门的见证和距离剖面全部为空,导航器和卡死规则退回到地图。分组台账把时间记在当时开启的那一组上,并逐次决策记录变化(死亡、击杀、受伤次数、卡死与停在门前的决策、地图覆盖率、眼睛目击),而不是直接读取关卡计数器,因为地图的击杀计数器在一个引擎上会跨越重生保留、在另一个引擎上则会清零 [2]。驱动程序在同一个引擎上交替运行眼睛组与盲组,两组都在同一层关卡上、以同样的重生方式游戏。
最初的观察。修复之后,对运行中的控制台做了 75 次轮询:地图判定有敌人在视野内的有 20 次,眼睛持有敌人卡片的有 44 次,见证步骤改变判定的有 1 次。两者一致时,一致得很紧密:眼睛的一张卡片位于 −23.2°、3.2 米(置信度 0.6),旁边是地图对同一名守卫的判定,位于 −23.5°、3.23 米。
3.3 眼睛开与关
测量运行的命令是 python -m wolf_floor.ablate --level MAP01 --skill 3 --block 120 --blocks 6:在同一个引擎上交替进行六个 120 秒的时段,眼睛组先开始,每组三个。表 1 是它打印出的台账;图 2 以“眼睛组比盲组”的比值展示三项事件率。
| 眼睛开 | 眼睛关 | 说明 | |
|---|---|---|---|
| 游戏时间(秒) | 359.9 | 360.4 | |
| 决策数(每秒) | 2,780 (7.72) | 2,913 (8.08) | 眼睛组的决策频率低 4.5% |
| 死亡 | 7 (1.17/分钟) | 6 (1.00/分钟) | 各时段:2、3、2 对 3、1、2 |
| 每分钟击杀 | 2.5 (≈15) | 2.0 (≈12) | |
| 每分钟受伤次数 | 6.17 (≈37) | 4.99 (≈30) | 生命值下降的决策次数 |
| 卡死决策占比 | 5% | 8% | |
| 停在门前的决策占比 | 36% | 35% | |
| 覆盖率(不可比较) | 30% | 33% | 最后一个时段是眼睛关 |
| 每分钟眼睛目击 | 2.17 (≈13) | 0 | 未看见 → 看见,式 (1) |
3.4 这些数字说明什么
持平。眼睛现在参与了决策:在地图线段判为未看见的地方,每分钟约有两次目击让 ATTACK 变得可容许。它没有可测量地改变结果。每组三个时段、只在一层关卡上,各时段的死亡数完全重叠,每个比值的区间都跨过 1。我们把这报告为持平,而不是哪一组的小胜。
混杂因素。四个由之前控制台重启遗留下来的 ECWolf 孤儿引擎,在整个测量期间都以满速运行,正在运行的控制台自己的引擎也是如此:连同本次运行自己的引擎,机器上共有六个引擎。它们在运行结束时被发现并终止,控制台此后也改为停止时关闭自己的引擎(提交 7693b88)。由于时段交替,两组共同承受了这种资源争用;但引擎是实时运行的,而眼睛每看一次都要花时间,这可能正是眼睛组决策频率低 4.5% 的原因。眼睛与老师的逐列一致率是会话开始以来的累计比例,它从 0.854(38 秒,1,043 个敌人样本)降到 0.77(128 秒,8,912 个),测量结束时为 0.577,敌人样本 23,833 个。VDSG 报告的是四个类别投票、没有敌人类别时的 79% [2];敌人是更难的类别,这一下降在意料之中,但我们没有把它单独分离出来。同样,眼睛在这次运行中自身的测距误差为 26%(600 个样本得到的距离常数为 38.3),而 VDSG 报告中是 7%(常数 33);原因我们也没有分离。
这次修复是必要的:一只没有敌人样本的眼睛无法为敌人作证。但它不足以改变驾驶员在这层关卡上的成绩。第 7 节会回到原因。
4 · B:为引擎声明作证的见证者(vcard-eye)
4.1 老师
BZFlag 是一款开源的 3D 坦克游戏;在我们的竞技场里,每辆坦克都是自己的游戏客户端,由自己的驾驶员驾驶 [4]。客户端上的一个补丁 FloorEye 让引擎成为老师。它每秒最多在十个时刻、在渲染器内部、就在缓冲区交换之前,读取坦克自己的帧与深度缓冲,写出一个配对:这一帧,以及关于它的真相。对其他每一辆坦克,它把坦克的有向包围盒(八个角点)用绘制场景时同一组视图矩阵与投影矩阵投影出来,报告屏幕方框、距离、方位与可见比例:方框在屏幕内的比例,乘以方框内 5×5 深度采样网格中没有被比坦克自身深度范围更近的东西遮挡的比例;它还用同样的深度检验写出坦克的轮廓。炮弹和爆炸也会报告,报告的是它们被绘制成的广告牌(billboard)。它们是混合绘制的,不写入深度,所以老师无法测量它们遮住了什么;一发炮弹的广告牌半径为 2.5 米。后来的各版老师随着问题被发现,陆续补上了眼睛所需的东西(§5.3):
| 老师 | 新增 |
|---|---|
| 1 | 只有坦克 |
| 2 | 每一发飞行中的炮弹,标出我方炮弹 |
| 3 | 爆炸;每辆坦克的引擎标记“在墙内”和“透过传送场看到” |
| 4 | 我方视野被挡(我方坦克压进墙里);精简 HUD 也隐藏射击装填条 |
| 5 | 去掉锁定与路径点标记;记录正前方空旷地面的米数(已实现,尚未采集) |
视场直接从投影矩阵读出;早期版本取自一个引擎调用,而它返回的是以弧度表示的垂直视角,使每个方位都发生偏斜。一个采集器把配对转成标准样本(一张 PNG 帧加一个物体列表的 JSON 文件):含隐藏坦克声明的帧每秒最多保存四帧,其余每秒最多一帧。眼睛不从样本中读取任何与特定游戏相关的内容,这正是同一只眼睛能接入另一款游戏的原因。
4.2 为什么不用检测器
第一只眼睛是搜索式的。它把每一帧转成逐像素的颜色对数似然比图(坦克对背景,512 个颜色箱,与 VDSG 眼睛同一套量化 [2]),保留阈值之上、位于地面上的坦克可能站立之处的连通色块,并由色块高度读出距离。在 4,000 个样本中留出 1,000 帧评分,它找到了 89.7% 的可见坦克,精确率 3.5%:每帧 15.8 个误报,方位误差的 95 分位数为 1.37°。检查六帧留出帧后发现,误报几乎全是深色石墙的片段,既有近处的,也有沿地平线的(图 3)。在候选之上加一个学习得到的核验器(用 2,661 个真候选和 38,726 个假候选拟合,按 99% 精确率设定阈值),结果阈值被推到 1.0,召回率降到 1.8%。两次评分都用的是单帧留出,后来证明这种做法会美化一只眼睛(§4.4);真实数字只会更差。我们在两种配置之后就停了下来。与自由搜索的比较不是受控研究;它是我们改换问题的原因。
4.3 见证者,一步一步
见证者(vcard_eye/witness.py)接收这一帧,以及该帧时刻引擎的声明:只有类别、身份、距离和方位,从不包括老师的方框或可见比例。被见证类别(坦克)的声明会被判断;其他类别(炮弹、爆炸)不被见证,但会作为遮挡物放到屏幕上。
1. 看哪里。记图像宽度为 \(w\)、水平视场为 \(\phi\),声明所在的列由其方位算出,其方框的上沿、下沿和宽度是 \(1/d\) 的曲线,用最小二乘在老师给出的精确方框上拟合:
其中 \(e_0\) 是宽度残差的 90 分位数。最先尝试的是单一规则“高度 \(=K/d\)”;它被大量远处的坦克主导,把近处坦克画得高出 20–25%、低出最多 15 像素,因为决定近处坦克下沿的是它最近的那个角,而不是它的中心。在完全位于画面内的 5,957 个老师方框上,这些曲线的中位误差上沿为 0.35 像素、下沿为 0.29 像素。在 \(\phi=60^\circ\)、640×400 下,50 米处的坦克预测为 62×26 像素,150 米处 26×9 像素,300 米处 17×5 像素。
2. 近者优先。声明按距离顺序判断。如果一条声明的预测方框至少有一半被眼睛已经确认的一辆更近的坦克覆盖,它就是未看见:那些像素属于更近的坦克。
3. 遮挡物。引擎报告的、比该声明更近的每一发炮弹和每一次爆炸,都像静态 HUD 一样从声明的窗口中屏蔽掉,屏蔽范围是它的光晕真正覆盖的区域:一个椭圆,大小为广告牌半尺寸的 \(s\) 倍再加 1.5 像素,其中 \(s\) 是测得的光晕范围的 90 分位数(§5.3)。交付的眼睛对炮弹取 \(s=0.72\)(来自 2,373 个清晰光晕),对爆炸取 \(s=0.87\)(2,412 个)。炮弹的屏幕位置随距离而定(曲线误差 0.31 像素);爆炸则不然(中位误差 10.8 像素),所以爆炸按引擎投影出的方框放置。如果这些光晕覆盖了声明方框的 70% 或以上,判定就是无法判断。由于光晕不写入深度,老师给出的可见比例会高估光晕后面摄像机实际拍到的部分,所以每个标签都使用有效比例 \(v_{\mathrm{eff}}=v\,(1-g)\),其中 \(g\) 是被屏蔽光晕覆盖的方框比例。
4. 眼睛不判断什么。引擎自己标记过的声明(在墙内、在传送场后面,或我方视野被挡)判为无法判断;距离近于 12 米的声明也是如此,因为此时方框溢出视野,深度老师也不可靠;窗口中至少一半被强光冲淡(亮度 ≥ 235)时同样如此。
5. 看。在窗口(预测方框加上 0.4 个方框高度和 2 像素的边距)中,眼睛计算 14 个可读的特征:方框中有多少是该类别的颜色、比周围一圈多出多少,这种颜色是否像墙带一样向两侧延续,纹理,对比度,方框内有没有一个亮高光、它是否比周围任何地方都亮,强光,该类别颜色最密集的一块,最亮点周围的光环,以及亮像素所占比例。方框上的一个 3×6 网格再为每个格子加入相对于周围一圈的亮度和该类别颜色的占比:又是 36 个,共 50 个。颜色模型是一个 512 箱的对数似然比,来自老师轮廓标为坦克的像素对背景像素;像素的似然比高于一个阈值时算作坦克颜色,阈值由交叉验证从 {0.5, 1.0, 1.5} 中选出(选中的是 1.5)。
6. 决定。核验器给出这条声明被看见的概率。它是一个梯度提升集成 [20]、[21],由 250 棵深度为 2 的树组成(对数损失、类别平衡、收缩率 0.1、每个特征 32 个分位箱、80% 的行子采样、固定随机种子),用纯 NumPy 编写,以 JSON 保存。一棵深度为 2 的树读起来就是一条规则。交付的眼睛中最强的一条是:
如果 方框内有亮高光 > 0.522 并且 方框第 1 行第 3 列的坦克颜色 > 0,那么 向看见 +1.12。
最先使用的是逻辑回归评分。它的证据只能相加,而眼睛最难的混淆恰恰是一种交互:饱和的高光,当周围是深色车身时是坦克最好的证据,当周围是一圈亮光环时却是炮弹的光晕。深度为 2 的树恰好能表达这个“并且”;软件包的单元测试要求这些树以超过 97% 的准确率学会一个两特征的“并且”。判定阈值在折外分数上设定(每个分数都来自从未见过其分块的核验器):取使隐藏声明被确认的比例不超过 0.25%(关口上限的一半)的最低分数,且不低于 0.5。在样本内分数上选出的阈值曾让 1.06% 的隐藏声明通过,而目标是 0.5%。交付的阈值为 0.947。在交付的眼睛里,树的分裂增益有 63% 来自方框内的高光,13% 来自它超出周围一圈的部分,9% 来自纹理,36 个网格格子合计占 7%。
7. 瞄准。被确认的声明成为一张卡片,其方位从像素读出:窗口中该类别颜色的质心。
4.4 评分与关口
同一辆坦克录像中相邻的帧相隔只有几秒,几乎一模一样。用单帧留出评分,实际上是在眼睛等于已经见过的帧上给它打分,早期几只眼睛的分数都因此被美化了。真正算数的评分采用按 60 个连续帧分块的 4 折交叉验证:样本按坦克和时间排序、切成分块,分块轮流进入各折,于是每条声明恰好被一只从未从其分块学习过的眼睛判断一次,而比赛的每个部分都出现在每一折中。代码注释说一个分块“约 20 秒”。在这里评分的数据中,一个分块的中位时长是 69.7 秒(10–90 分位 54–80 秒),因为采集器每辆坦克每秒只保存约 0.85 帧;留出的片段比原意更长,这让评分更严而不是更松。评分完全按游戏时的决策执行(近者优先、屏蔽、弃权、阈值),作用于保存下来的裁剪块,而单元测试确认这些裁剪块给出的特征与整帧完全相同。
4.5 接入一款游戏
任何能写出标准样本的实验线都可以在不写游戏专用代码的情况下接入。接入程序检查样本内容(可见与隐藏声明、遮挡物类别、老师版本、单一分辨率),每当新到 500 个样本时就在一个独立的低优先级进程中学习一轮,并在通过关口时停止。一个模型上下文协议服务器通过八个工具把这个循环开放给任何智能体会话:eye_check_samples、eye_onboard、eye_job、eye_jobs、eye_stop_job、eye_status(评分、关口,以及眼睛用平实语言写出的每一条规则)、eye_games 和 eye_judge;后者拒绝使用未通过关口的眼睛,除非显式覆盖。到目前为止,已接入的是一款真实游戏(BZFlag)和一款合成测试游戏;第二款真实游戏尚未接入。
5 · B:结果
5.1 关口运行
关口运行使用了磁盘上的全部老师 4 样本:7,863 帧,全部来自同一场 25 分钟的比赛,通过六辆坦克的摄像机拍到,其中三辆由我们的规则驾驶员驾驶、三辆由 BZFlag 的 AI 驾驶,每辆坦克 1,185–1,402 帧(每秒 0.79–0.93 帧)。这些帧中有 350 米内的坦克声明 6,206 条(老师标为可见 4,782、隐藏 1,323、部分可见 101)、炮弹声明 7,468 条(其中 3,483 条是我方的)和爆炸声明 5,777 条。没有任何坦克声明带有引擎标记,也没有任何一帧我方视野被挡,所以这两种排除从未被这批数据检验过。各折共用 132 个分块,其中五个跨越了两辆坦克的录像。在眼睛自身的排除之后,参与评分的是 3,959 条可见声明和 1,258 条隐藏声明。表 2 给出合并评分,表 3 给出四折。
| 检查项 | 结果 | 关口 |
|---|---|---|
| 召回率,≥4 像素的可见声明 | 0.984(3,959 条中 3,896 条;95%:0.980–0.988) | ≥ 0.98 |
| 误确认,隐藏声明 | 0.48%(1,258 条中 6 条;95%:0.18–1.04%;单侧 0.94%) | ≤ 0.5% |
| 测试的隐藏声明 | 1,258 | ≥ 400 |
| 眼睛自己的弃权(被强光冲淡) | 3,959 条中 0 条 | ≤ 2% |
| 无法判断:更近的光晕覆盖了它 | 602 | 不算漏检 |
| 无法判断:抵近距离(<12 米) | 65 | 不算漏检 |
| 部分可见,不评分 | 322(其中 118 条被判为看见) | |
| 瞄准误差,95 分位 | 从像素读出 0.55°;引擎自己的方位 0.13° |
| 折 / 尺寸 | 帧数 | 召回率 | 漏检 / 可见 | 误确认 / 隐藏 | 比率 |
|---|---|---|---|---|---|
| 第 1 折 | 1,980 | 0.987 | 12 / 952 | 5 / 387 | 1.29% |
| 第 2 折 | 1,980 | 0.997 | 3 / 1,075 | 1 / 214 | 0.47% |
| 第 3 折 | 1,980 | 0.981 | 18 / 948 | 0 / 351 | 0 |
| 第 4 折 | 1,923 | 0.970 | 30 / 984 | 0 / 306 | 0 |
| 小,4–7 像素 | 0.980 | 58 / 2,948 | 5 / 1,000 | 0.50% | |
| 中,8–19 像素 | 0.995 | 4 / 775 | 1 / 173 | 0.58% | |
| 大,20 像素及以上 | 0.996 | 1 / 236 | 0 / 85 | 0 |
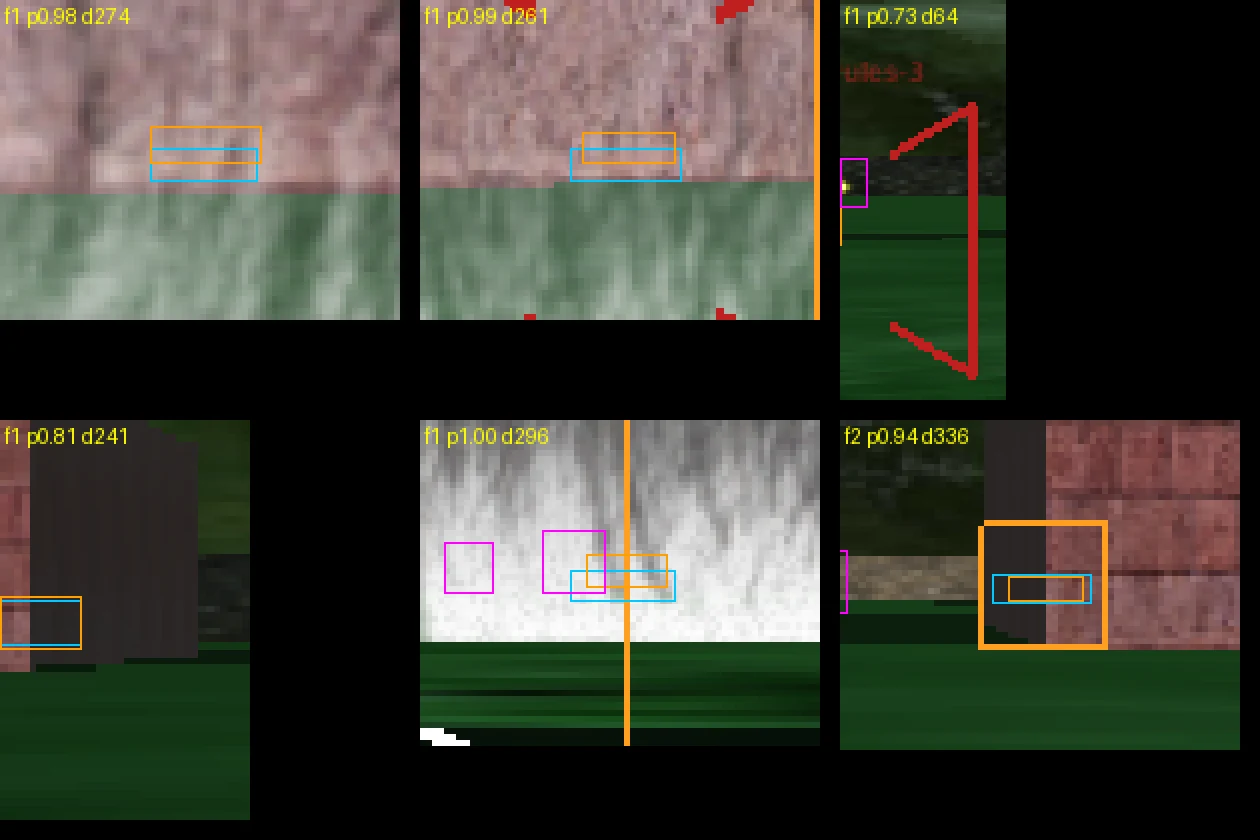
余量很薄。合并评分通过了关口。如果某一折单独拿出来,它就过不了:第 1 折在 387 条隐藏声明中误确认了 5 条(1.29%),第 4 折只找到了 0.970 的可见声明(图 4)。六条误确认并不是六个相互独立的事件:其中两条在同一帧。误确认率的 95% 区间上达 1.04%,是上限的两倍;召回率的区间下达 0.980,正好是上限本身。各折都来自同一场比赛,因此共享同一张地图、同一种光照和六辆坦克的习惯;分块能把相邻帧隔开,却隔不开这些。此外,最后几项设计选择(布局网格,以及只在半径至少 6 像素的光晕上测量光晕范围)正是依据这同一批帧、同一组折上的交叉验证结果做出的,所以关口运行并不是对最终设计的完全独立的检验。新地图上的现场比赛(§5.4)才是针对这一点的核查。
六条误确认是什么。图 5 展示了每一条在作出判定时的画面。两条在同一帧,来自一台紧贴墙面的摄像机,而引擎并没有报告我方视野被挡,于是整个窗口都是墙面纹理。一条是 BZFlag 围绕其 AI 目标画出的红色锁定括号,即使目标被墙挡住也照画不误;老师 5 会隐藏这些标记,但还没有采集任何老师 5 样本。一条是一帧被白色条纹覆盖的画面。两条是落在远处深色墙面上的预测方框——正是自由搜索的那种混淆,如今罕见了,但并未消失。这些解读来自目视检查,并不是测量得到的原因。
瞄准。从像素读出的方位不如引擎自己的方位准确(95 分位分别为 0.55° 与 0.13°)。见证者的存在是为了说明要不要相信引擎的声明,而不是取代引擎的几何。
5.2 眼睛是怎么走到这一步的:演化曲线
每个想法出现当天测得的数字,来自不同版本的老师和单帧评分,把它们拼接起来,画出的曲线有一部分只是数据本身在变化。因此,眼睛的每一个阶段都在同样的 7,863 帧上、用同样的折、以仅由引擎几何固定下来的标签,重新学习并重新评分(表 4、图 6)。每个阶段都是今天的代码关掉后来加入的部分,而不是检出当天的代码。这种评分在两个方面比关口的评分更严。每一辆隐藏坦克都要计入,即使它在光晕后面或者我方视野被挡,因为确认它就等于一次盲射,不论它前面有什么。对一条可见声明弃权算作漏检。
| 阶段 | 新增了什么 | 特征数 | 召回率 | 误确认 | |
|---|---|---|---|---|---|
| 最初的见证者 | 颜色和一个高光,一个逻辑回归评分 | 10 | 96.1% | 15 (1.14%) | 未通过 |
| + 光晕线索 | 光晕的光环;高光周围的深色车身 | 14 | 79.5% | 7 (0.53%) | 未通过 |
| + 屏蔽炮弹 | 屏蔽光晕像素 | 14 | 78.3% | 2 (0.15%) | 未通过 |
| + 引擎标记 | 被标记的声明不作判断 | 14 | 78.3% | 2 (0.15%) | 未通过 |
| + 决策树 | 用“并且”规则代替求和 | 14 | 92.7% | 3 (0.23%) | 未通过 |
| + 炮塔布局 | 方框上的 3×6 网格 | 50 | 98.4% | 6 (0.46%) | 通过 |
光晕线索先伤后补。光晕线索用五个特征取代了一个特征(窗口中最亮的像素):方框内的高光、它超出周围一圈的部分、强光、最亮点周围的光环,以及亮像素所占比例。把它们加进逻辑回归评分,误确认减半,召回率却损失 16.5 个百分点,因为证据求和无法区分“亮点并且深色车身”与“亮点并且光环”。同样这十四个特征放进深度为 2 的树中,召回率回升到 92.7%。3×6 布局网格把它提到 98.4%:远处的坦克只是几个像素的深色车身加一个亮顶,只有布局能说明这一点。在同一张表、同一组折上(使用当时的光晕范围)做出的决定中,网格把召回率从 0.952 提到 0.989,把小坦克漏检从 144 降到 37,把误确认从 1,252 条中的 5 条降到 4 条。屏蔽炮弹光晕让误确认从 7 条降到 2 条,代价是召回率下降 1.3 个百分点。引擎标记在这里什么也没改变,因为这些帧里没有任何声明被标记。
评分方式会移动曲线。这种评分的一个早期版本没有给光晕后面的隐藏坦克评分;在那个版本下,最初的见证者在 1,255 条中误确认了 5 条(0.40%),而不是 1,315 条中的 15 条(1.14%)。被评分的眼睛是同一只,所以多出来的十条误确认全都是光晕后面的隐藏坦克:正是后面几个阶段要消除的那种混淆。逐日的分数同样无法相互比较:最初的见证者在较早数据的单帧留出上得到召回率 0.916、188 条中误确认 2 条,第一只采用 \(1/d\) 曲线的眼睛得到 0.963、188 条中 2 条;第一只按分块评分、使用老师 2 数据的眼睛,召回率 0.962、误确认 0.20%,没有通过关口。
5.3 耗费了好几个小时的发现
我们自己的炮弹停在目标上。一个径直远离摄像机飞去的光晕在屏幕上几乎不动,所以我方炮弹在飞行的全程都停在它所射向的那辆坦克上——包括一辆被墙挡住的坦克。在老师报告炮弹之前,眼睛会凭我方炮弹的光晕“确认”隐藏的坦克。老师 2 报告每一发炮弹并标出我方的,见证者把它们屏蔽掉(第 3 步)。
光晕比它的广告牌小。老师把一发炮弹报告为它被绘制成的 2.5 米广告牌。屏蔽整个方框屏蔽过度了:在较早的老师 2 与老师 3 数据上,眼睛对 2,691 辆可见坦克中的 444 辆无法判断(16.5%)。在像素中测量 551 个清晰的光晕,光晕亮度降到峰值(高于背景部分)15% 处的半径,在 30 到 350 米的每个距离段都只有广告牌半径的 0.31–0.34(表 5)。按测得的范围(其 90 分位数,在那批数据上为 0.57)屏蔽后,无法判断的可见坦克降到 2,691 辆中的 227 辆(8.4%)。学习程序现在在自己的数据上按遮挡物类别分别测量这一范围:关口运行中炮弹为 0.72,爆炸为 0.87。
| 距离 | 光晕数 | 半高半径 | 边缘半径 | 广告牌半径 | 边缘 / 广告牌 |
|---|---|---|---|---|---|
| 30–60 米 | 18 | 8.0 像素 | 10.5 像素(0.86 米) | 30.5 像素 | 0.34 |
| 60–120 米 | 61 | 4.0 像素 | 5.0 像素(0.84 米) | 16.0 像素 | 0.31 |
| 120–200 米 | 139 | 2.0 像素 | 3.0 像素(1.00 米) | 9.0 像素 | 0.33 |
| 200–350 米 | 330 | 1.0 像素 | 2.0 像素(1.13 米) | 6.0 像素 | 0.33 |
墙上的“=”其实是 HUD。两条出现在远处墙面上、也出现在远处坦克方框上的灰色短条,起初被当成 BZFlag 在坦克部分陷进墙里时画在墙上的“跨维度灯光”。它们其实是射击装填指示,画在屏幕中心右侧的一个固定位置(HUDRenderer.cxx 第 1750–1752 行)。静态像素的 HUD 屏蔽会漏掉它,因为它的长度随装填而变化。老师 4 的精简 HUD 把它隐藏了。
深度老师看不见光晕。炮弹和爆炸是混合绘制的广告牌,不写入深度,所以一辆一半藏在光晕后面的坦克,在深度检验看来完全可见,而摄像机只拍到它的一半。因此每个标签都使用有效可见比例 \(v(1-g)\)(第 3 步)。还有两个较小的引擎事实必须测量而不能假设:爆炸在屏幕上的大小不是距离的函数(\(1/d\) 规律的中位误差为 10.8 像素),以及最先用于获取视场的引擎调用返回的是以弧度表示的垂直视角。
5.4 现场:28 场新地图比赛
关口只对一场比赛的帧评分。现场眼睛判断每辆坦克客户端写出的每一帧(每辆坦克每秒约七帧),并按关口自己的定义,对照同一配对中的老师给自己评分。从现场评分与关口对齐后的第一场比赛(9 月 26 日 22:11)到竞技场论文的截止点(9 月 27 日 01:05:50 结束的那场比赛),共有 28 场比赛运行了现场眼睛:98.5 分钟游戏、250,966 帧判断,每场比赛一张新的随机地图 [4]。其中十场是我们的三辆规则坦克对阵三辆 BZFlag AI 坦克;十八场是驾驶员学习循环的 A/B 比赛:两辆坦克用当前驾驶员、两辆用候选驾驶员,对阵两辆 BZFlag AI 坦克。眼睛判断每一辆坦克的视角,AI 坦克也不例外。这段时间里眼睛没有重新学习:它保存的配置文件与关口运行时的逐字节相同,它的学习历史里只有那一轮。
现场召回率合并为 0.982,交叉验证为 0.984(图 7);逐场在 0.963 到 0.995 之间,28 场中有八场低于 0.98。这八场全部是驾驶员学习循环在 00:19 之后的 A/B 比赛,那时循环正在改换它的驾驶员;此前循环的八场 A/B 比赛阵容相同,全都在 0.98 以上。眼睛没有变化。我们没有调查驾驶员新的交战方式是否能解释这一下降。现场眼睛在 162,185 次隐藏判定中误确认 37 次(0.023%),对 20,288 条声明无法判断。两种误确认率不可比较。相邻帧上的现场判定重复着同一个局面,所以合并计数远不是独立试验;而关口的样本是刻意富集了隐藏声明的,现场的隐藏声明却没有按难度挑选。诚实的解读更窄:在 28 张眼睛从未见过的地图上,它的召回率保持在交叉验证值附近,并没有崩溃。
排除项。两场更早的现场比赛被排除在外,原因记录在运行它们的会话中。第一场(22:02,召回率 0.815,51 次误确认)中,眼睛在我方坦克阵亡时仍在判断,并且判断了超出其 350 米训练范围的声明;那时还没有射击计数器。第二场(22:07,召回率 0.936)中,现场评分仍使用比关口更宽松的可见性规则,而且射击是对照离炮线最近的敌人评分,而不是驾驶员的提前量目标。这两点都在 22:11 那场比赛之前修正了。
6 · B:这一核对在扳机处值多少
6.1 判定如何到达决策
坦克收到的每一份引擎状态,都会为其中列出的每个敌人标上眼睛的判定,前提是该判定不超过 0.35 秒;否则这个敌人被标为没有新鲜观察。见证开火开启时,我们的规则驾驶员只向眼睛当前确认的敌人开火,否则扣住开火(“已对准:扣住开火,眼睛看不见它”);语言模型坦克的开火会被扣住,除非眼睛确认了离其炮线最近的敌人;BZFlag 自带的 AI 从不查询眼睛 [4]。我们坦克的每一发炮弹事后都对照最新配对中的老师评分,评分针对驾驶员自己的提前量目标。决定这一节结论的细节在眼睛上游:规则驾驶员只与引擎报告视线畅通的敌人交战——视线要延伸到距该敌人一米之内——并且在射程之内(bzflag_floor/pilot.py,提交 9ecdb4a)。见证者叠加在一个本来就在问几乎同一个问题的引擎检验之上。
6.2 核对开与关时的射击
受控的一对比赛。两场连续的 3 分钟比赛使用同样的代码,都是三辆规则坦克对阵三辆 BZFlag AI 坦克,区别在于见证开火(以及,和每场比赛一样,随机地图)。开启时,我们的坦克开火 48 发、盲射 0 发,扣住开火 4 次;关闭时,开火 58 发、盲射 0 发。驾驶员的视线检验本来就避免了每一次盲射。
放到整个竞技场来看。在竞技场论文截止点之前、结果中记录了射击评分的每一场计入比赛里,不论有没有门控,盲射都很少:开启见证开火时 197 发中 1 发(三场比赛),关闭时 3,012 发中 10 发(24 场比赛) [4]。门控开启时的那一发盲射出现在 22:07 那场比赛,采用的是早期按炮线确定目标的评分方式(§5.4)。没有任何比赛在门控开启时运行过语言模型坦克。
6.3 每一次扣住开火,逐一评分
从 22:52 那场比赛起,黑匣子会记录每一发炮弹和每一次扣住开火,以及当时眼睛的判定和老师给出的目标可见比例。唯一一场开启见证开火并有黑匣子的 3 分钟比赛中,有 75 发炮弹,每一发的目标都经眼睛确认、老师也显示可见,另有 26 次扣住开火(表 6)。
| 扣住开火那一刻的目标 | 次数 | 眼睛的判定 |
|---|---|---|
| 抵近距离,0.2–1.3 米(没有老师读数) | 12 | 无法判断(全部是同一次遭遇:一辆坦克、一个敌人、1.75 秒) |
| 至少一半可见 | 12 | 未看见 6,无法判断 3,没有新鲜判定 2,看见 1 |
| 部分可见(20%) | 2 | 未看见 2 |
| 隐藏 | 0 |
26 次中的十二次是同一次近距离遭遇:按设计,眼睛不判断 12 米以内的坦克,于是驾驶员对着一辆几乎不可能打偏的坦克一次又一次地扣住开火。另外十二次针对的是老师显示至少一半可见的目标:原因是眼睛的漏检、弃权和过时的判定。有一次扣住开火发生时,眼睛最新的判定是看见,这一不一致我们没有调查。没有一次针对隐藏目标。在紧随其后的那场见证开火关闭的比赛中,眼睛仍在判断:61 发炮弹的目标全部可见,其中 55 发眼睛已经确认,5 发判为未看见,1 发没有判定。如果门控开启,这 6 发——驾驶员火力的 10%——都会被扣住,尽管没有一发是盲射。
6.4 这说明了什么
在这个竞技场、这些比赛里,这一核对没有阻止任何我们能测到的盲射,反而让我们少打了炮弹:在抵近距离,以及它的召回率不足之处。这不是眼睛评分的缺陷——它的评分在现场守住了。这是第一见证者本来就正确时,第二见证者所能有的价值。规则驾驶员自己的视线检验依据引擎的几何回答几乎同一个问题,而且答得很好。这一核对真正的用途,是约束一个我们没有编写其瞄准方式的驾驶员:一个按自己选择的方位开火的语言模型坦克,或者一个根本不存在引擎检验的平台。对模型扳机的门控已经实现并有单元测试把关,但还没有在比赛中测量过。在 12 米以内——眼睛无法框住目标的地方——信任引擎的视线,是降低抵近代价的显而易见的办法;它尚未实现。
7 · 讨论
7.1 为什么核对声明比搜索更容易
我们没有做受控比较,所以这里讲的是这次转变为什么在此处奏效,而不是一条定理。眼睛不再搜索之后,有三件事发生了变化。
问题变小了。引擎提供了类别、距离和方位,所以眼睛知道坦克必须在哪里、必须有多大(式 2):300 米处是 17×5 像素。这么小的东西,靠颜色在深色墙面纹理中是找不出来的——自由搜索的眼睛正是在试图这样做——但在引擎指明的那一处核对它,已经足够。
错误按声明计数,而声明很少。关口运行的帧里平均每帧 0.79 条坦克声明(7,863 帧中 6,206 条)。检测器必须在每一帧里排除每一段墙;它自己的关口要求每一百帧最多一个误报,而它每帧产生 15.8 个。见证者只为引擎指明的那几处作答,误确认按隐藏声明计数——而这正是关乎开火的情形。
它可以拒绝,且理由可以核查。抵近距离、方框上的光晕、引擎标记、强光:每一次弃权都有写明的原因,而关口禁止眼睛靠自己的弃权来换取召回率。
这些作为思想都不是新的。“假设—验证”式的识别,是拿一个位姿假设去对照图像,而不是重新搜索物体 [8]、[9]、[10];“由合成而分析”把感知看作用图像检验假设 [11]。这里特别之处在于假设从哪里来:来自驾驶员本来就信任的引擎。同一个事实也限定了见证者。它看不见引擎没有声明的任何东西。在 BZFlag 中引擎声明了每一辆坦克;在一个物理平台上,声明将来自其他传感器或地图,见证者的召回率不可能比它们更好。
7.2 一只眼睛值多少,取决于读取它的决策值多少
两条实验线都做出了一只按自身标准行之有效的眼睛,而在决策处都没有测得出的收益。在德军总部中,眼睛从零个敌人样本,变成每分钟约两次让 ATTACK 变得可容许的目击,而死亡、击杀和受伤次数保持持平。在 BZFlag 中,眼睛通过了严格的关口,并在 28 张新地图上守住了召回率,而它所启用的门控没有阻止任何我们能测到的盲射,因为驾驶员自己的视线检验早已阻止了它们。
只看眼睛的评分,这两个结果都不会显现出来。第二见证者只有在第一见证者缺席或出错的地方才能发挥作用,而这种情况有多频繁,是驾驶员和引擎的属性,而不是眼睛的属性。德军总部中心到中心的线段对半藏的守卫是错的,所以见证者在那里找到了用武之地——每分钟约两次目击——但在一层关卡上每组三个时段的规模下,还不足以改变结果。BZFlag 的视线检验几乎总是对的(没有门控时 3,012 发中 10 发盲射),所以见证者在那里找到的主要是代价。我们得到的教训是程序性的:先给眼睛评分,然后在它所服务的决策处测量,把眼睛开和关各测一遍。
7.3 见证者应当拥有多大的权限
两条实验线赋予见证者的权限不同。在 BZFlag 中,门控只能取消射击;就像作用于动作的屏蔽 [19] 一样,它不能让驾驶员做任何它本来不会做的事,它的代价是它扣住的火力。在德军总部中,见证者可以让一个地图判为未看见的敌人变得可交战,所以它扩大了驾驶员可以攻击的范围。这一权限在构造上受到限定(只针对雷达列出的物体、只在屏幕之内、只在有匹配卡片时),而且它改变的是计算可容许集合所依据的事实,绝不是一条指令。哪种设计正确,取决于对具体平台而言哪种错误更糟:漏掉一发,还是盲射一发。两条实验线在眼睛如何获得权限上也不同。BZFlag 的眼睛在通过一个固定的、经交叉验证的评分之前不能启用门控,而且它所应用的每一条规则都可以用文字打印出来;德军总部的眼睛在线学习,没有这样的关口,只有确认规则的边界。这是德军总部实验线的一个缺口,而不是我们会为之辩护的设计选择。
8 · 局限与效度威胁
- 关口背后只有一场比赛。所有 7,863 帧评分帧都来自同一场 25 分钟的比赛、同一张随机地图,经由六辆坦克的摄像机拍到。各折分隔的是连续分块,而不是地图或比赛,所以交叉验证的评分衡量的是这场比赛之内的推广。28 场现场比赛(新地图、同一只眼睛)是仅有的超出这场比赛的证据,而它们由现场计数评分,计入的是相关的帧。
- 设计是在被评分的数据上选定的。布局网格和测量光晕范围的规则,是依据关口运行随后评分的同一批 7,863 帧、同一组折上的交叉验证结果选定的。关口的阈值在运行之前就已提交(30401f2),但设计并没有在看到数据之前冻结,所以交叉验证的评分存在未知程度的乐观偏差。
- 余量很薄。合并评分通过了;95% 区间上达 1.04% 的误确认、下达 0.980 的召回率;两条上限都不是每一折都能满足;六条误确认中有两条在同一帧。换一场比赛再做一次关口运行,可能就会失败。
- 未经检验的排除项。关口数据中没有任何坦克声明带有引擎标记,也没有任何一帧我方视野被挡,所以这些弃权从未被评分检验过。六条误确认中有两条来自一台贴着墙的摄像机,而引擎没有标记它。老师 5(去掉锁定标记、记录前方空旷地面)已经实现,但从未采集。
- 每条线各只有一款真实游戏。见证之眼已接入 BZFlag 和一款合成测试游戏,没有接入第二款真实游戏;“与游戏无关”描述的是代码和样本格式,不是一项测量结果。
- 决策处的测量规模很小。BZFlag 的受控比赛对是两场 3 分钟的比赛;被评分的扣住开火来自一场 3 分钟的比赛;没有任何比赛在门控开启时运行过语言模型坦克。德军总部的比较是一层关卡上每组三个 120 秒时段,同时有四个孤儿引擎和运行中控制台的引擎在争用处理器,覆盖率指标无法区分两组,也没有造成伤害的计数。
- 保存在会话日志中的证据。大多数数字来自已提交的证据文件(关口报告、保存的眼睛、演化曲线)或比赛记录文件。有些数字只以两个会话日志中记录的工具输出形式留存:自由搜索的结果、早期见证者的评分、光晕范围诊断与布局网格比较、六条误确认的清单、德军总部的敌人样本计数与轮询,以及德军总部的台账——台账自己的 JSON 文件写在一个已不存在的会话临时目录里。论文的声明文件为每一项列出了日志行号,我们的提取脚本在模式不匹配时会报错退出,但这些数字无法从已提交的文件重新推导出来。
- 粗粒度的老师。老师给出的可见比例,是在方框内取 5×5 个深度样本、以 0.75 个坦克长度为深度容差得出的,所以靠近 0.5 和 0.05 阈值的标签会继承这种粗糙,而关口和现场计数都以它为评分依据。
- 依靠目视检查的解读。六条误确认和自由搜索误报的成因,是对图像的解读,不是测量。
- 测试没有重新运行。软件包的 18 个单元测试会端到端接入那款合成游戏,但本文写作时没有重新运行它们:准备本文时测试机器的系统卷已满,我们也不想与正在那里运行的实验争用资源。该实验线的会话日志记录了这 18 个测试在软件包最后一次提交(74bd4ed)前不久全部通过。
- 没有第三方复现,而且各实验线与本文的作者是同一个团队。
10 · 结论
我们着手为游戏驾驶员造一只可以信任的眼睛,并测量了两件事:眼睛有多好,以及它改变了什么。对第一个问题,答案在其限度之内是令人鼓舞的。把问题从“找出坦克”换成“这辆被声明的坦克是否被拍到?”,让同样的颜色统计从一个精确率 3.5% 的检测器,变成一个交叉验证召回率 0.984、误确认 0.48% 的见证者,而这个评分在 28 张新地图上守在了 0.982;余量很薄,关口数据只来自一场比赛。对第二个问题,答案很直白。在《德军总部 3D》中,修好一只原本什么决策都没接上的眼睛,驾驶员的成绩依然持平。在 BZFlag 中,一个在眼睛确认之前扣住开火的门控,没有阻止任何我们能测到的盲射,因为驾驶员自己的视线检验早已阻止了它们;以一场比赛来判断,它会扣住驾驶员对明明可见的目标约十分之一的射击,并在一次抵近遭遇中连续扣住开火十二次。
两个结果指向同一个方向。一只眼睛的评分说明它可以被托付什么;它所服务的决策说明托付它是否有任何价值。因此,下一批测量要放在第一见证者薄弱的决策处:一个没有人为其编写瞄准方式的语言模型驾驶员;在 12 米以内、眼睛无法框住目标的地方信任引擎的视线;在另一场比赛、另一张地图上再做一次关口运行;以及通过同一个工具接入第二款真实游戏。
参考文献
- Perslis Research. TinkyVision: Let There Be Sight — continuous, low-latency vision for any model. Technical report, 2026. research.perslis.com/tinky-vision
- Perslis Research. VDSG: A Commanded Admission-Control Runtime for Autonomous Agents. Systems paper, 2026. research.perslis.com/vdsg
- Perslis Research. Fail-First Models: Failure Becomes Structure. 2026. research.perslis.com/fail-first
- Perslis Research. Rules at the Wheel: Tanks, Language Models and an Honest Loss. Empirical study, 2026. research.perslis.com/tank-arena
- P. Viola, M. Jones. Rapid object detection using a boosted cascade of simple features. In Proc. IEEE CVPR, vol. 1, pp. I-511–I-518, 2001. doi:10.1109/CVPR.2001.990517
- R. Girshick, J. Donahue, T. Darrell, J. Malik. Rich feature hierarchies for accurate object detection and semantic segmentation. In Proc. IEEE CVPR, pp. 580–587, 2014. doi:10.1109/CVPR.2014.81
- J. Redmon, S. Divvala, R. Girshick, A. Farhadi. You Only Look Once: unified, real-time object detection. In Proc. IEEE CVPR, pp. 779–788, 2016. doi:10.1109/CVPR.2016.91
- D. G. Lowe. Three-dimensional object recognition from single two-dimensional images. Artificial Intelligence 31(3):355–395, 1987. doi:10.1016/0004-3702(87)90070-1
- D. P. Huttenlocher, S. Ullman. Recognizing solid objects by alignment with an image. International Journal of Computer Vision 5(2):195–212, 1990. doi:10.1007/BF00054921
- M. A. Fischler, R. C. Bolles. Random sample consensus: a paradigm for model fitting with applications to image analysis and automated cartography. Communications of the ACM 24(6):381–395, 1981. doi:10.1145/358669.358692
- A. Yuille, D. Kersten. Vision as Bayesian inference: analysis by synthesis? Trends in Cognitive Sciences 10(7):301–308, 2006. doi:10.1016/j.tics.2006.05.002
- S. R. Richter, V. Vineet, S. Roth, V. Koltun. Playing for data: ground truth from computer games. In Computer Vision – ECCV 2016, LNCS, pp. 102–118, 2016. doi:10.1007/978-3-319-46475-6_7
- M. Kempka, M. Wydmuch, G. Runc, J. Toczek, W. Jaśkowski. ViZDoom: a Doom-based AI research platform for visual reinforcement learning. In Proc. IEEE Conference on Computational Intelligence and Games (CIG), pp. 1–8, 2016. doi:10.1109/CIG.2016.7860433
- V. Vapnik, A. Vashist. A new learning paradigm: learning using privileged information. Neural Networks 22(5–6):544–557, 2009. doi:10.1016/j.neunet.2009.06.042
- D. Chen, B. Zhou, V. Koltun, P. Krähenbühl. Learning by cheating. Conference on Robot Learning (CoRL), 2019. arXiv:1912.12294
- P. M. Frank. Fault diagnosis in dynamic systems using analytical and knowledge-based redundancy: a survey and some new results. Automatica 26(3):459–474, 1990. doi:10.1016/0005-1098(90)90018-D
- P. Antonante, D. I. Spivak, L. Carlone. Monitoring and diagnosability of perception systems. arXiv:2011.07010, 2020.
- L. Sha. Using simplicity to control complexity. IEEE Software 18(4):20–28, 2001. doi:10.1109/MS.2001.936213
- M. Alshiekh, R. Bloem, R. Ehlers, B. Könighofer, S. Niekum, U. Topcu. Safe reinforcement learning via shielding. In Proc. AAAI Conference on Artificial Intelligence 32(1), 2018. doi:10.1609/aaai.v32i1.11797
- J. H. Friedman. Greedy function approximation: a gradient boosting machine. The Annals of Statistics 29(5), 2001. doi:10.1214/aos/1013203451
- T. Chen, C. Guestrin. XGBoost: a scalable tree boosting system. In Proc. 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 785–794, 2016. doi:10.1145/2939672.2939785
- J. H. Friedman, B. E. Popescu. Predictive learning via rule ensembles. The Annals of Applied Statistics 2(3), 2008. doi:10.1214/07-AOAS148
- D. R. Roberts, V. Bahn, S. Ciuti, M. S. Boyce, J. Elith, G. Guillera-Arroita, S. Hauenstein, J. J. Lahoz-Monfort, B. Schröder, W. Thuiller, D. I. Warton, B. A. Wintle, F. Hartig, C. F. Dormann. Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure. Ecography 40(8):913–929, 2017. doi:10.1111/ecog.02881
- C. J. Clopper, E. S. Pearson. The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika 26(4):404–413, 1934. doi:10.1093/biomet/26.4.404
- E. B. Wilson. Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association 22(158):209–212, 1927. doi:10.1080/01621459.1927.10502953
- L. D. Brown, T. T. Cai, A. DasGupta. Interval estimation for a binomial proportion. Statistical Science 16(2), 2001. doi:10.1214/ss/1009213286
附录 A · 数字从哪里来
本文的每一个数字都在论文的声明文件(CLAIMS.md,随论文源文件一起提供)中列出了来源。来源分为四类:BZFlag 实验线已提交的证据(关口报告、保存的眼睛与演化曲线,与眼睛存储中的副本逐字节相同)、它在正文所列提交处的代码(眼睛为 30401f2–74bd4ed,现场接线为 9ecdb4a)以及老师补丁(4eb684a–c7aada9);比赛记录(每场比赛的元数据、结果、计分板,以及从 9 月 26 日 22:52 起的逐发射击黑匣子)和老师样本的 JSON 元数据;VDSG 实验线在 71b94d1 与 7693b88 处的代码;以及两个会话日志中记录的工具输出,用于 §8 所列的那些数字。
复现这些数字。在论文目录下,用 python3 -B 依次运行 analysis/transcript_extract.py(会话日志摘录)、analysis/eye_stats.py(关口、保存的眼睛、演化曲线、老师数据、现场比赛,以及被评分的射击与扣住开火)和 analysis/wolf_stats.py(德军总部台账的推导计数与检验),然后运行 analysis/make_figdata.py(图表数据)。这些脚本只读取;-B 防止 Python 往实验线里写字节码。写作本文时没有运行任何游戏、控制台、竞技场、学习轮次或演化循环。
图。图 3 与图 5 是带有实验线自身诊断叠加层的已记录老师帧,经过裁剪,没有重新渲染。其余每一幅图都由旁边表格中的数字绘制;在这个网页版中,图 1、2、4、6 与 7 由与 PDF 相同的数字重新绘制。
附录 B · 交付的眼睛,用文字写出来
眼睛自己的说明由它的 eye_status 工具从保存的配置文件中打印出来,列出了它应用的每一条规则。最强的五条树路径(把提升过程中近似副本树的相同条件合并、票数相加)是:
- 如果 方框内有亮高光 > 0.522 并且 方框第 1 行第 3 列的坦克颜色 > 0,那么 向看见 +1.12;
- 如果 方框内比周围任何地方都亮 > 0.075 并且 第 2 行第 3 列的坦克颜色 > 0,那么 +0.45;
- 如果 第 1 行第 4 列的坦克颜色 > 0.111 并且 斑驳纹理 > 0.046,那么 +0.43;
- 如果 方框内的坦克颜色比周围多得多 > 0.082 并且 斑驳纹理 > 0.036,那么 +0.33;
- 如果 方框内比周围任何地方都亮 > 0.075 并且 强烈呈现坦克颜色 > −1.74,那么 +0.24。
行与列从左上角起计数预测方框上的 3×6 网格。第一条规则是两条线索的“并且”,这是逻辑回归评分无法表达的:方框内的高光,加上方框上部中间的坦克颜色——我们把那里读作远处坦克的炮塔。
如何引用
Perslis Research. A Witness, Not a Detector: Checking What a Game Engine Claims Against the Pixels. Research prototype, September 2026. https://research.perslis.com/witness-eye
@techreport{perslis2026witnesseye,
  title       = {A Witness, Not a Detector: Checking What a Game Engine Claims Against the Pixels},
  author      = {{Perslis Research}},
  institution = {Perslis Research},
  year        = {2026},
  month       = {9},
  note        = {Research prototype; simulation and games; not a certified safety system.},
  url         = {https://research.perslis.com/witness-eye}
}